1つのリクエスト、複数のエージェント。
気に入った結果を残しましょう。
同じタスクを、ひと操作で2〜4個のCLIやモデルに渡せます:Claude CodeとCodex、または同じCLIの2つのモデル。各エージェントは専用のgit worktreeで作業し、どれかを選ぶまでメインのチェックアウトは動きません。
公開されたベンチマークが示すのは、他人のリポジトリでモデルがどうだったかです。ここで分かるのは、あなたのリポジトリで、実際に片付けるべきチケットでどうなるかです。
ログインのリダイレクトループを修正して
main、最後のコミット
race-1-claude- 3 ファイル
- +42 -11
- 6 分
race-2-codex- 5 ファイル
- +88 -23
- 9 分
race-3-antigravity- 2 ファイル
- +31 -19
- 4 分
3つのエージェント、1つのリクエスト、3つのworktree。数字は一例です:差分を読んで選ぶのはあなたです。
Claude CodeとCodexの比較記事はどこにでもありますが、そのほとんどは、あなたのものではないリポジトリでテストしています。知りたいのは、あなたのスタック、あなたの規約、このバグにどのエージェントが対応できるかです。それを確かめる直接的な方法は、両方に同じリクエストを渡して2つの差分を読むことです。
手作業なら、worktreeが2つ、ターミナルが2つ、同じプロンプトを2回貼り付け、それから開始時のコミットに対してそれぞれの差分を取ることになります。これでも動きますし、このページに正確なコマンドを載せています。AgentsRoomはこれを1つのランチャーにまとめ、動かせる17個のエージェントCLI(Claude、Codex、GitHub Copilot CLI、Cursor、その他13個のエージェントCLI)のどれでも使えます。
AgentsRoomは結果を採点せず、勝者も選びません。エージェントごとに同じ数字と差分全体を示し、残すと決めたものをマージするボタンを用意します。
比較でできること
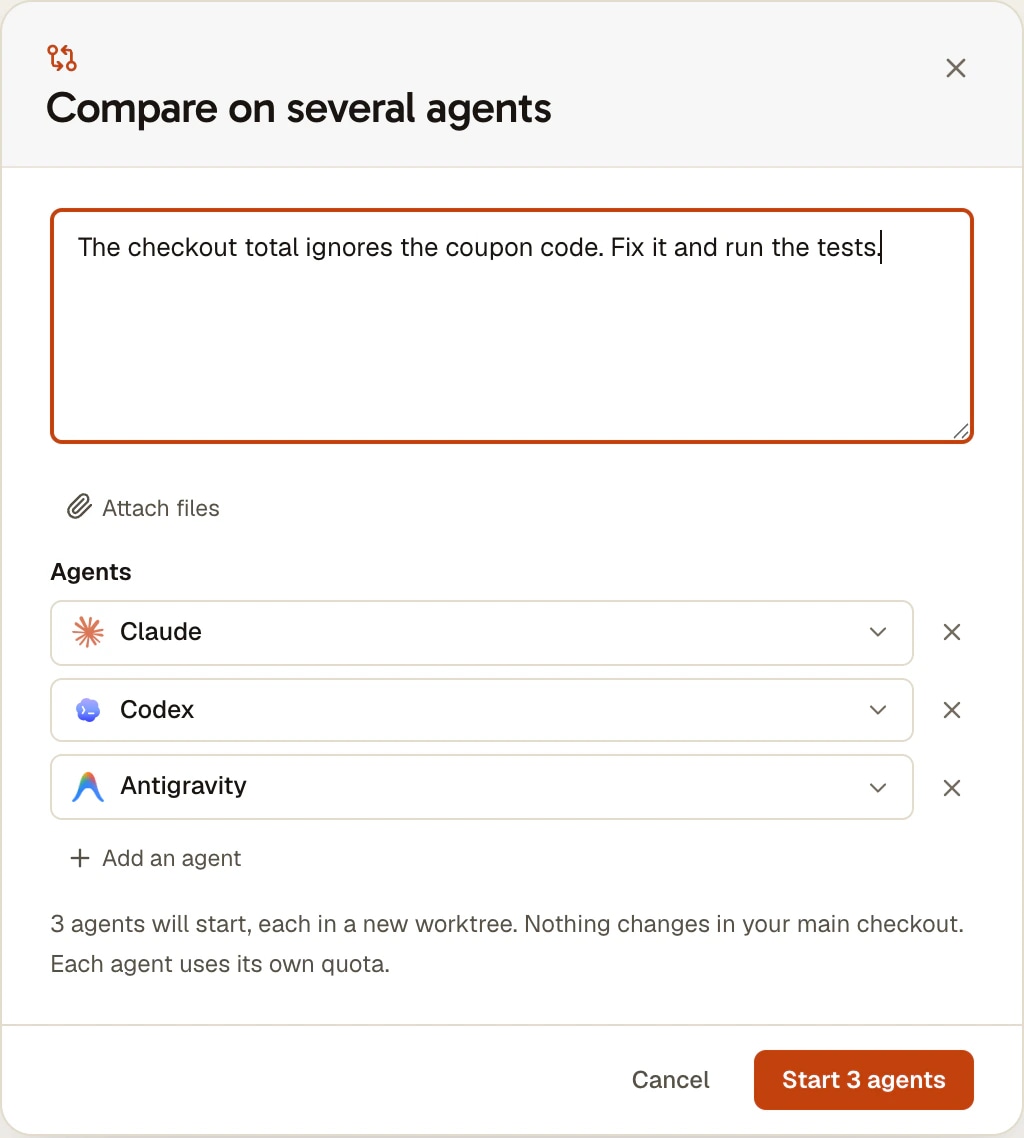
選択済みの3つのエージェント
ランチャーは3つのCLIが選択された状態で開くので、起動するだけで始められます。各行でプロバイダー、モデル、エフォート、アカウントを変更でき、行数は2〜4行の範囲で変えられます。同じCLIの2つのモデルは2つのエージェントとして数えます。
エージェントごとに新しいworktree
各エージェントは、現在のHEADから切り出した専用のブランチとworktreeを受け取ります。まだプッシュしていないコミットも含まれます。worktreeを作成できなければその行だけが失敗し、他は起動します:エージェントがメインのチェックアウトで代わりに動くことはありません。
作業中も横に並べて
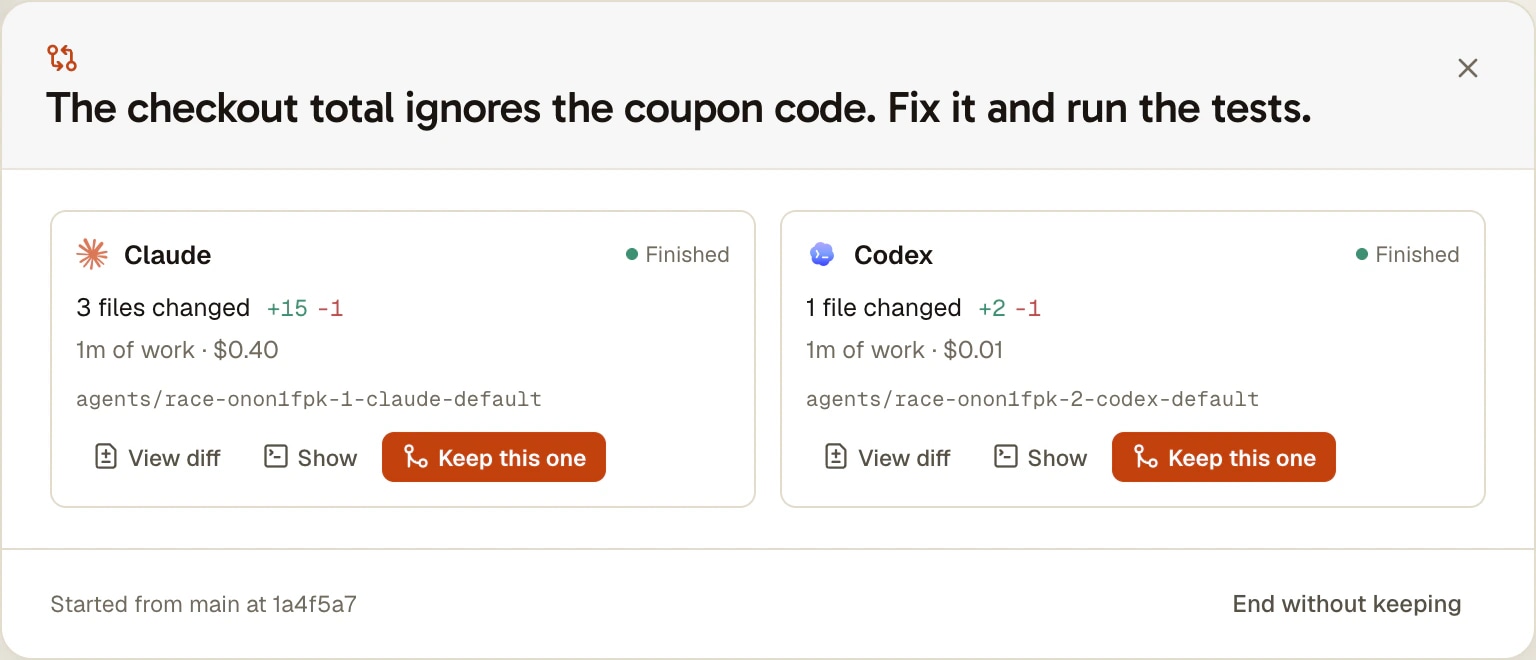
ペインは横一列に、エージェントが4つなら正方形に開きます。上のバーが各エージェントを追跡します:起動中、作業中、あなたの操作待ち、完了、失敗。その後、画面が勝手に動くことはありません:比較の終わりは、「比較」ボタン付きの通知で知らせます。
エージェントごとに1枚のカード
変更ファイル、追加・削除行数、作業時間、そしてCLIが報告する場合はトークンまたはコスト。「差分を表示」を押すと、そのエージェントが行ったすべてが、コミット済みかどうかを問わず、開始時のコミットと比較してタブで開きます。
これを残す
何が起きるかを示す確認のあと、そのブランチを開始元のブランチにマージします。エージェントが未コミットのまま残したものは、先にそのブランチでコミットされます。コンフリクトが起きるとマージは取り消され、チェックアウトは元の状態のままです。
スマートフォンから起動
iOSとAndroidのアプリから比較を起動して追跡できます:実行するのはコンピューターで、その画面には触れません。エージェント一覧の上のカードに各エージェントの状態が表示されます。比較とマージはコンピューターで行います。
比較の実行方法
リクエストからマージまで5つのステップです。
- 1
ランチャーを開く
プロジェクトで稲妻ボタンを開いて「複数のエージェントで比較」を選ぶか、エージェント一覧の下部にある「新しいエージェント」から「エージェントを比較」を選びます。リクエストを入力し、タスクに必要ならファイルを添付します。
- 2
エージェントを選ぶ
3つのCLIが準備されています。行をクリックして変更し、行を追加または削除できます。起動できない行には「CLI が未インストール」または「クォータ上限」と表示され、数に入りません。ランチャーは、どの未コミットファイルがworktreeに含まれないかも示します。
- 3
起動
「3 個のエージェントを起動」をクリックするか、Cmd/Ctrl+Enterを押します。worktreeが順番に作成され、各エージェントがリクエストを最初のメッセージとして受け取り、ペインが横に並んで開きます。途中でどのエージェントにも返答できます。
- 4
比較
完了すると、「比較」でエージェントごとのカードが開きます。数字を読み、読む価値のあるものは「差分を表示」で開き、質問したいエージェントのコンソールは「表示」で呼び戻します。
- 5
1つを残し、残りを片付ける
「これを残す」は、確認のあとそのブランチをマージします。その後アプリは、他のエージェントを閉じてworktreeを削除することを提案し、失われるものを先に一覧表示します。断って、あとで「他を片付ける」で行うことも、「残さずに終了」で抜けることもできます。
AgentsRoomなしで行う同じ比較
これに私たちのアプリは必要ありませんし、この方法は知っておく価値があります。各エージェントには専用のフォルダーが必要で、そうしないと2つ目が1つ目を上書きします。これらのコマンドは2026年11月5日にテスト用リポジトリで実行しました。
BASE=$(git rev-parse HEAD)
git worktree add -b try/claude ../try-claude HEAD
git worktree add -b try/codex ../try-codex HEAD

# one terminal per folder, the same request in each
cd ../try-claude && claude "fix the login redirect loop"
cd ../try-codex && codex "fix the login redirect loop"

# back in your main checkout: what did each one change?
git -C ../try-claude add -N . && git -C ../try-claude diff --stat $BASE
git -C ../try-codex add -N . && git -C ../try-codex diff --stat $BASE
2つのエージェントコマンドを、フォルダーごとに別々のターミナルで実行し、進行に合わせて返答します。新しいファイルを数字に含めるには、先にgit add -Nでマークします。通常のgit diffは未追跡ファイルを無視するからです。結果を1つ残すには、そのフォルダーでコミットし、メインのチェックアウトからそのブランチをマージしてから、不要になったworktreeとブランチを削除します。
他のツールが提供するもの(2026年11月時点)
これは私たちだけのアイデアではなく、他のツールのほうが進んでいる点もあります。日付は各ページを読んだ日です。
Cursor
Cursor 3には/best-of-nコマンドがあり、1つのタスクを複数のモデルで、それぞれ専用のworktreeで実行します。親エージェントが結果にコメントし、異なる実装の一部を1つのコミットにマージできます。これはAgentsRoomにはできません。比較するのはCursor内のモデルです(Cursorのフォーラムの投稿、2026年11月5日に確認)。
VS Code
VS CodeのAgentsウィンドウには、Compare ModelsがPreview機能として記載されています:同じタスクを複数のモデルで実行し、結果を並べて表示します。このウィンドウのその他の機能と、私たちより多くのことができる点は、比較ページで扱っています。
Orca
Orcaはエージェントごとに1つのworktreeを軸に作られており、同じバグを3つのエージェントに渡す例を示しています。このワークフローに最も近いツールで、そのために別のランチャーを必要としません。違いは比較ページに載せています。
AgentsRoomが加えるもの
比較は、異なるモデルだけでなく異なるCLIの間でも行えます。Claude CodeとCodexが、それぞれのツールとあなた自身のサブスクリプションで向き合います。クォータルールは各行に適用され、残したエージェントはプロジェクトの通常のエージェントとして作業を続けます。
制限事項
- プロジェクトは少なくとも1つのコミットがあるgitリポジトリである必要があり、チェックアウトはブランチ上にある必要があります。
- メインのチェックアウトの未コミットの変更はworktreeに含まれません:worktreeは最後のコミットから始まります。ランチャーは起動前にその旨を伝えます。
- 各エージェントはそれぞれのクォータを消費します:3つのエージェントならリクエストの3倍のコストがかかります。プランの上限やマシンの予算に達すると、エージェントは空きを待ち、自動的に起動します。
- このコンピューターにチェックアウトされ、エージェントがSSHホストで動くプロジェクトは比較できません。ここで切り出したworktreeはホストに存在しないからです。サーバー上で直接開いたプロジェクトなら比較できます。
- 比較は起動したコンピューターで実行され、アカウントの別のマシンやマシンプールのマシンで実行されることはありません。
- ファイル数と行数はgitから取得します:未追跡の新しいファイルは1ファイルとして数え、行数は付きません。プロジェクト統計をオフにしている場合、作業時間は不明になります。
- スマートフォンからは起動と追跡ができますが、添付はできません。比較、マージ、片付けはコンピューターで行います。
- 2026年11月5日にバージョン1.254.0でリリースされ、現時点ではmacOSで手動テストしています。WindowsとLinuxは同じgit呼び出しを実行しますが、まだ手動テストはしていません。
よくある質問
Claude CodeはCodexより優れていますか?
リポジトリとタスク次第です。だから私たちはランキングを公開していません。2026年11月5日までの4週間にAgentsRoomでCodexを起動したアカウントのうち、84%がClaude Codeも起動しています:多くの人が両方を使い続けています。役に立つテストは、あなた自身のものです:両方に同じ実際のチケットを渡し、2つの差分を読み、結論を出す前に2〜3種類の異なるタスクで繰り返してください。
自分のコードでClaude CodeとCodexを比較するには?
同じコミットから、両方に同じリクエストを渡し、それぞれ専用のgit worktreeで作業させ、そのコミットに対するそれぞれの差分を取ります。AgentsRoomでは「複数のエージェントで比較」ランチャーがこれにあたります。使わない場合のコマンドはこのページにあります:エージェントごとにgit worktree add、フォルダーごとにターミナル1つ、開始時のコミットに対してgit diff。
選ぶ前に、比較が現在のブランチに影響しますか?
いいえ。各エージェントには専用のworktreeとブランチがあります。ブランチを変更するのは「これを残す」だけで、それも確認のあとに限られます。その間にチェックアウトが別のブランチに移っていた場合、「これを残す」はその旨を伝えて拒否し、他の場所には何もマージされません。
比較のコストはどのくらいですか?
エージェントの数だけリクエストの回数分かかり、各CLIのクォータまたはAPIキーで消費されます:AgentsRoomが比較ごとに料金を追加することはありません。ランチャーは起動前にエージェント数を知らせます。実際のバグや複数ファイルにまたがる機能など、選択が重要なタスクに使い、小さな変更のたびには使わないでください。
同じCLIの2つのモデルを比較できますか?
はい。ランチャーの各行にプロバイダー、モデル、エフォート、アカウントがあるので、2つのClaudeモデルを並べることも、同じモデルを2つのエフォートレベルで比較することも、同じCLIを2つのアカウントで比較することもできます。
Cursorのbest-of-nとの違いは?
Cursorの/best-of-nは、Cursor内で1つのタスクを複数のモデルで、それぞれ専用のworktreeで実行し、親エージェントが結果にコメントして複数の試行の一部をマージできます。AgentsRoomは異なるモデルに加えて異なるCLIも、あなた自身のサブスクリプションで比較し、判断はあなたに任せます:数字と差分を示し、ブランチ全体を1つマージします。出典:Cursor 3に関するCursorのフォーラム投稿(2026年11月5日に確認)。
AgentsRoomが最良の結果を選んでくれますか?
いいえ。変更行数やかかった時間は品質についてほとんど何も語らず、スコアはそれを隠してしまいます。別の意見が欲しければ、「これを残す」をクリックする前に、別のエージェントに差分のレビューを依頼してください。
エージェントがクラッシュしたり、マージがコンフリクトしたりしたら?
クラッシュしたエージェントは「失敗」と表示され、他は続行します。エージェントを閉じたりアプリを再起動したりしても比較は戻り、閉じたエージェントも比較して残すことができます。マージがコンフリクトすると取り消され、チェックアウトは元の状態に戻ります:そのエージェントにコンフリクトの解決を依頼してから、もう一度残してください。
どのCLIを比較できますか?
AgentsRoomが対応する17個のエージェントCLI(Claude、Codex、GitHub Copilot CLI、Cursor、他13個)のうち、コンピューターにインストールされサインイン済みのものすべてです。作業時間はすべてのCLIで分かります。トークンやコストは、それらを報告するCLIでのみ表示されます。
このページの関連情報
こちらもおすすめ
Git worktree
AIエージェントやチケットごとに専用のgit worktreeを用意し、すぐにビルドできる状態に整えます(依存関係をインストール、.envをコピー)。レビュー、コミット、マージまで1つのウィンドウで行えます。
Claude と Codex の併用
新しいエージェントを Claude Code と Codex に振り分けます。チケット 2 件に 1 件ずつ、または Claude のセッションを 10% 使ったら次は Codex の週を 10%。2 つのサブスクリプションを順番にではなく、同じペースで消費します。あとはクォータルールにおまかせください。
マルチプロバイダー
AgentsRoomは17のAIコーディングプロバイダーをサポート:Claude、Codex、GitHub Copilot CLI、OpenCode、Antigravity CLI、Aider、Grok Build、Mistral Vibe、Kimi Code、Amp、oh-my-pi、Freebuff、Devin、Cursor、Command Code、Muse Code、Pi。エージェントごとに異なるプロバイダーを割り当て、会話中にプロバイダーを切り替え、自動ハンドオフでコンテキストを保持。最良のマルチプロバイダーAIコーディングツールです。
行き詰まっているチケットで試してみましょう
AgentsRoomをダウンロードし、リクエストを1つ入力して、2つのエージェントがどう扱うかを読んでください。
コンパニオンアプリ:外出先でもエージェントを確認
Claude、Codex、Antigravity CLI、またはその他の AI プロバイダーを使用します。
バグや要望を公開バックログに直接送信できます。
