メッセージごとに最適なモデルを、
エージェントを再起動せずに
Adaptive Mode を「すべてのメッセージ」オプションと「自動」でオンにすると、各メッセージが送信される前に AgentsRoom がその仕事をきちんとこなせる最も安いモデルを選び、Claude Code や Codex のエージェントは再起動なし、入力も一切なしでそのモデルに切り替わります。名前の変更は Haiku へ、アーキテクチャの質問は Opus のままです。
インストールは不要です。プラグインも、起動するプロキシも、サードパーティのキーもいりません。新規インストールではデフォルトで有効になっており、設定からオフにできます。モデルを選ぶために、メッセージの最初の 500 文字が AgentsRoom のサーバーに送られます。他の CLI では、コンポーザーの上のチップがモデルを提案し、ワンクリックで適用できます。
表示される内容
切り替えはすべて、いつも見ている場所に表示されるので、どのモデルが応答したかが常にわかります。
コンポーザーの上に「Haiku に切り替えました」
送信した直後、コンポーザーの上のチップがこのメッセージ用に選ばれたモデルを表示します。判定を待つ間(最大 4 秒)は「モデルを選択中…」と表示されます。
エージェントのモデルピルも追従
モデルが変わるとエージェントのモデルピルがアニメーションするので、エージェントを一目見るだけで、今どのモデルが作業しているかがわかります。
実際に使われたモデルをバッジで確認
どのモデルが応答したかを API 自体が報告すると、チップにチェックマークのバッジが表示されます。カーソルを合わせると「API で確認済み: (モデル名)が応答しました」と表示されます。
今のモデルで十分なら「Opus を維持しました」
すべてのメッセージで切り替えが必要なわけではありません。すでに使っているモデルが適切なら、チップがそう伝え、エージェントはそのモデルのままです。
親指アイコンで選択を評価
各チップには高評価と低評価の親指アイコンがあります。ワンクリックで、モデルがメッセージに合っていたかを AgentsRoom に伝えられ、次からの選択が改善されます。
節約の成果は使用量パネルに
使用量パネルでは、今月あなたのメッセージのうち何件がより安いモデルに回されたかを、デスクトップでもスマートフォンの「使用量」タブでも確認できます。
「自動」は今のところ Claude Code、Codex、oh-my-pi で、オンにした後に起動したエージェントに対して動作します。他の CLI では、同じチップがモデルを提案し、受け入れるかどうかを選べます。
Adaptive Mode は各タスクを、それをきちんとこなせる最も安いモデルに割り当てます。軽い作業には Haiku、バランスの取れた作業には Sonnet、重い作業には Opus。タスクあたりのコストは減り、1日あたりのタスク数は増えます。
AIコーディングエージェントを動かすうえでのお金の問題はこうです。どのモデルにも価格があり、安いモデルとフラッグシップの差は大きい。Claude Opus は最も高性能で、最も高価。Claude Haiku は最も安い。Claude Sonnet はその中間です。たいていの人は1つのモデルを選んだまま放置するので、難しいタスクには力不足になるか、はるかに多いケースとして、簡単なタスクに払いすぎることになります。
1日の中でエージェントに実際に何を頼んでいるか考えてみてください。タイポの修正。変数のリネーム。UI文字列の翻訳。短いユニットテストの作成。ドキュメントの要約。どれもフラッグシップを必要としません。それを全部 Opus で動かせば、まったく同じ結果のために、必要の何倍もの速さでプランの利用予算を燃やすことになります。この無駄は目に見えません。だからこそ積み重なっていくのです。
Adaptive Mode はそのギャップを埋めます。メッセージを書くと、下書きを読み取り、タスクが本当はどれくらい難しいかを見極め、プロバイダーのラインアップの中でそれでもしっかり仕事をこなせる最も安いモデルを提案します。デフォルトでは会話の最初のメッセージでこれを行います。「すべてのメッセージ」をオンにすればメッセージごとに行い、「自動」に設定すればメッセージが送信される前にエージェントが切り替わります。重量級のモデルは、それに値する仕事のために温存されます。アーキテクチャ、セキュリティ監査、大規模なリファクタリング。それ以外はすべて、ほんの一部のコストで済むモデルへ回されます。
アプリ内で撮影した実際のセッションです。新しい Claude Code エージェントは Opus で起動します。README のタイポ修正を頼むと、メッセージが送信される前に Haiku に切り替わり、再起動もターミナルへの入力もありません。続いて同じ会話でアーキテクチャの質問をすると、すぐに Opus に戻ります。
なぜモデルをタスクに合わせるのか
簡単なタスクで払いすぎるのをやめましょう。タイポ修正にフラッグシップを使うのはお金を燃やすようなものです。Adaptive Mode は軽い作業を軽量モデルへ誘導するので、些細なタスクは最上位ティアで払う額のほんの一部で済みます。
難しい問題のためにパワフルなモデルを取っておきましょう。サイズの最適化は、常に安く済ませることではありません。タスクがシステム設計やセキュリティ監査なら、Adaptive Mode は上のモデルへ切り替えるよう伝え、深さを必要とする仕事が実際にそれを得られるようにします。
同じプランで1日あたりのタスク数を増やせます。タスクあたりの予算が少なくなれば、利用上限に達するのが遅くなります。1日全体、そして並列で動く多数のエージェントを通じて、節約は積み重なり、実際のスループット増加になります。
ワークフローの摩擦はゼロ。提案は送信前にコンポーザーの上に小さなチップとして現れます。ワンクリックで適用。探し回るメニューも、どのモデルが合うかの手動の当て推量も、作業の遅延もありません。
経済の話:消費を減らし、より多くこなす
同じエージェント、同じプラン。違いは、各タスクが予算をどれだけ食うかです。
すべてに1つのモデル
- : どのタスクも、選んだままにしてあるモデルで動きます。
- : タイポや翻訳にフラッグシップを使うと、本来の何倍ものコストがかかります。
- : そのパワーを必要としなかった仕事で、プランの利用予算が一気に減ります。
- : その日のうちに早く利用上限の壁にぶつかり、エージェントが止まります。
- : モデルを手動で切り替えるのは面倒なので、誰もやりません。
Adaptive Mode オン
- : 各タスクは、それをきちんとこなせる最も安いモデルに割り当てられます。
- : 軽い作業は軽量モデルへ回され、ほんの一部のコストで済みます。
- : フラッグシップはリファクタリング、監査、アーキテクチャのために温存されます。
- : タスクあたりの予算が少なくなれば、利用上限の前にこなせるタスクが増えます。
- : ワンクリックで適切なモデルが適用されるので、サイズの最適化が実際に起こります。
ルーティング自体はほぼ無料です。小さく高速なモデルが1セントよりはるかに少ないコストで分析を行い、あとは邪魔をしません。
何をするのかを書く。
エージェントは正しいモデルで開く。
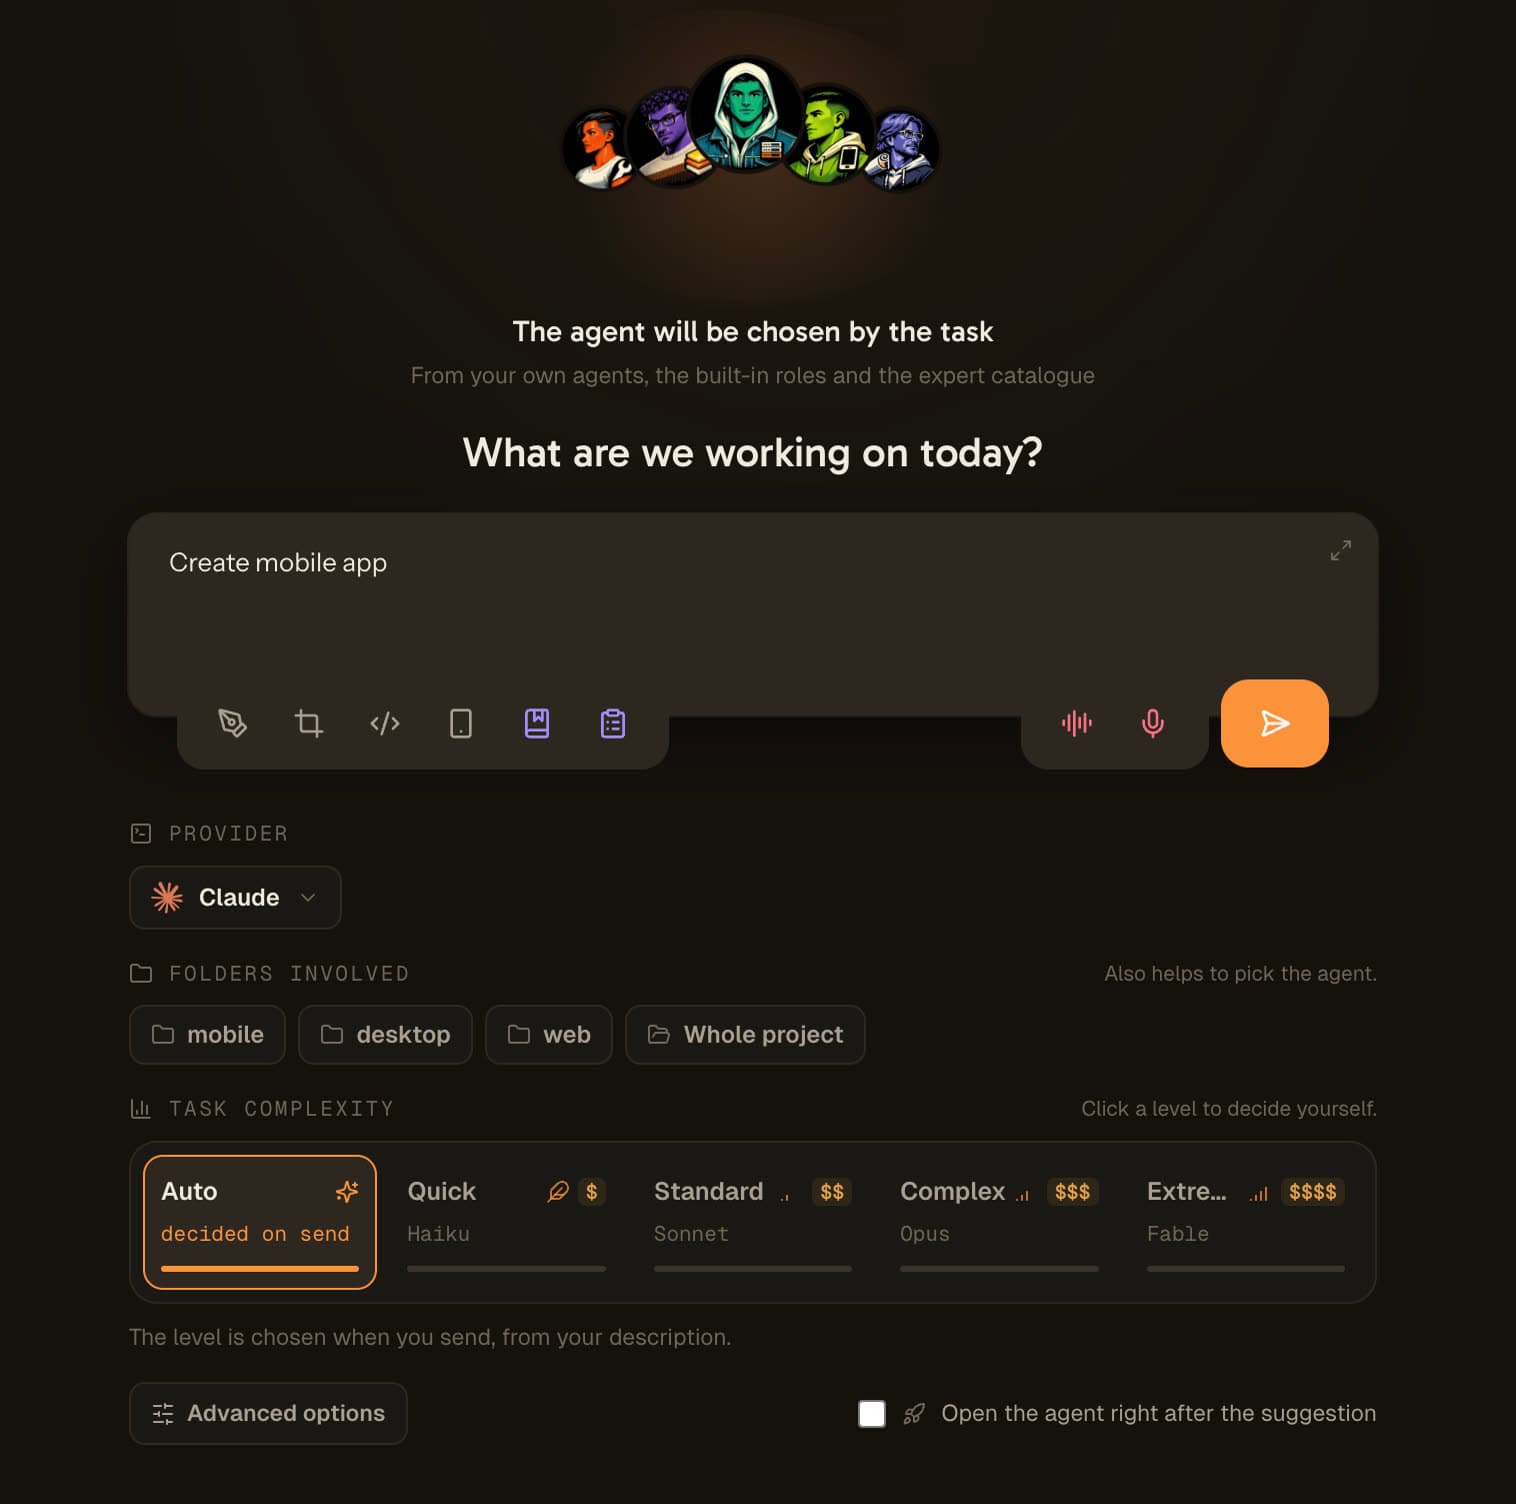
AI Suggestion は同じ判断を、何のコストもかからない唯一の瞬間、つまりセッションが存在する前に移します。エージェントのカードにある提案ボタン、またはまだエージェントを選んでいないときはワークスペースのドックの上にあるバーのボタンをクリックすると、ターミナルの代わりに、このエージェントがこれから何をするのかを尋ねる入力欄が一つだけ現れます。一文で答えます。一度の呼び出しがそれを読み、モデルとセッション名を返し、エージェントを選んでいなければ、どのエージェントが引き受けるべきかも返します。
そしてセッションが開きます。設定はすでに済んでいて、あなたの一文が最初のメッセージになっています。何も貼り付けていないし、CLI の起動を待ってから直したわけでもないし、タイポを直すのにフラッグシップの料金を払ってもいません。
一文が入る。複雑さのレベルが一つ点灯する。そのレベルに対応するモデルで、セッション名も付いた状態でエージェントが開く。
なぜセッションが開く前に決めなければならないのか
同じ提案、同じモデル、まったく違う結末。変わるのは、いつ尋ねられるかだけです。
ターミナルが開いた後に尋ねる場合
- : CLI は設定されていたモデルですでに起動しています。
- : プロンプトは書き終わっていて、送信まであと一打鍵です。
- : 今モデルを変えるのは、始めたばかりのセッションを捨てることです。
- : 提案は邪魔としか受け取られず、閉じられます。
- : 些細なタスクを結局フラッグシップが処理し、何も学ばれません。
セッションが存在する前に尋ねる場合
- : まだ何も始まっていないので、取り消すものがありません。
- : あなたはすでにタスクを説明しています。それこそが判断に必要な入力です。
- : モデルもセッション名もエージェントも、一度の呼び出しで決まります。
- : セッションは設定済みで開き、あなたの説明が最初のメッセージになります。
- : 安いモデルを選んでも何も失わないので、実際にそうなります。
これがこの機能のすべてです。より賢い提案ではなく、同じ提案を、はいと言うのが無料な瞬間に出すこと。
四つのレベルを、あなたのプロバイダーの実際のモデルに対応させる
複雑さのレールは、この判断の目に見える部分です。自動のままにしておけば、分析がレベルを一つ点灯させます。自分でレベルをクリックすれば、それがあなたの決定になります。何も送信されず、セッションはすぐに開きます。
簡易
01ロジックのないテキストや設定の修正。タイポ、ラベル、翻訳文字列、バージョン番号の更新。フラッグシップモデルが決して見るべきではないレベルであり、そして最も頻繁に受け取っているレベルです。
標準
02解決方法がすでに分かっている小さな変更。ボタンに状態を追加する、既存のコンポーネントをつなぐ、短いテストを書く。調べることは何もなく、やる作業があるだけです。
複雑
03作るべき機能、調べるべきバグ、進めるべきリファクタリング。最初は道筋が見えないので、モデルには一つの方針を決める前に探索する余地が必要です。
最高難度
04アーキテクチャ、監査、原因の分からない問題。フラッグシップモデルはこのために存在します。そしてこうしたタスクに限って使うからこそ、ここで使う余裕が生まれます。
機能の中にモデル識別子は一切書かれていません。四つのレベルは、エージェントが動いているプロバイダーのカタログから、高性能な順に並べて解決されます。そのプロバイダーが四つ未満のモデルしか提供していない場合、表は上に向かって畳まれます。モデルが三つなら、複雑と最高難度がどちらもフラッグシップに着地し、その逆にはなりません。過小に見積もれば実行一回分が丸ごと無駄になり、過大に見積もっても呼び出し一回分の価格差で済みます。
AI Suggestion の流れ、一歩ずつ
六つのステップ、そのうち四つは任意、そして呼び出しは合計で一度だけ。
提案を頼む
エージェントのカードにあるきらめきのボタン「プロンプトからモデルを提案」をクリックするか、タスクにエージェントまで選ばせたいならワークスペースのドックの上にあるバーのボタンを押します。意図を尋ねる画面が開きます。アニメーションする背景に置かれたエージェントの顔、一つの入力欄を指す矢印、そして気が変わったときのために、その下に「そのまま開く」リンク。いつもどおりエージェントをクリックすれば、これまでどおりすぐに開きます。
タスクを一文で説明する
普通の言い回しで、自分の言葉で。プロンプトでもなく仕様でもなく、このエージェントがこれから何をするのか。この一文だけが必須の入力で、そのままセッションの最初のメッセージになります。
任意:関係するフォルダを指す
プロジェクトのフォルダがフォルダの形をした小さなチップで並びます。一つクリックするとエージェントに作業範囲が与えられ、難易度の見積もりも鋭くなります。同じバグでも、モバイルアプリの中と Web サイトの中では同じタスクではないからです。
任意:詳細オプションを開く
入力欄の下に畳まれています。仕事の種類、誰のための仕事か、期待する成果物、コミットしないやテスト必須といった約束事、そして貼り付けたエラーやチケット番号のような自由な文脈。これらは同じ呼び出しで一緒に送られ、エージェントの最初のプロンプトの先頭に付けられます。
一度の呼び出しで決まる、あるいは呼び出しゼロ
自動のままなら、送信すると一つのリクエストが飛び、レベル、モデル、セッション名、そしてエージェントが未指定ならエージェントを返します。代わりに自分でレベルをクリックすれば、リクエストは一切ありません。そのレベルに対応するモデルで、セッションがすぐに開きます。
セッションが、設定済みで開く
エージェントは選ばれたモデルで、生成されたセッション名の下に起動します。あなたの説明は、起動後にターミナルへ貼り付けられるのではなく、CLI 自身の起動引数を通して最初のメッセージとして渡されます。
エージェントすら選ばなくてかまいません
エージェントを指定せずにこの画面を開くと、質問の幅が広がります。オーブには三つの顔に囲まれた疑問符が表示され、あなたが打った一文が誰がタスクを引き受けるかを決めます。すでにあなたのルームにいるエージェント、十四の標準ロール、あるいはカタログにいる約 260 人の専門家の中から。
新しいプロジェクトを作ったときに出てくるのも、今はこれです。何かを作らなければならないという理由だけでフルスタックのエージェントを黙って作ることは、もうありません。何に取り組むのかを尋ね、その答えが求めるエージェントを選びます。
エージェントも、モデルも、セッション名も、同じ一度の呼び出しから返ってきます。三つのリクエストをつなげば、ターミナルを開いて後からモデルを直すより速いことだけが価値であるこの画面の待ち時間が、三倍になってしまうからです。
セッションが開いた後の、一つの質問
エージェントが動き出すと、細いバーが一度だけ尋ねます。提案されたモデルは適切でしたか。答えは三つ:役に立った、軽すぎた、重すぎた。
二つではなく三つなのは、間違っていたという答えでは使えないからです。使えるのは間違いの方向です。軽すぎたと重すぎたは正反対の修正であり、どちらへ動けばいいのかを判断基準に伝えられるのは方向だけです。
このバーが何かを妨げることはなく、質問はセッションごとに一度だけで、答えが送られるのは利用データの共有をオンにしている場合だけです。
標準はボタン一つ、効果のあるところだけ自動に
あなたが頼まない限り、この画面があなたとターミナルの間に割り込むことはありません。エージェントをクリックすれば、この機能ができる前とまったく同じように開きます。提案はボタン一つで呼び出せて、自動モードをオンにするかどうかはあなた次第です。
そのまま開く
入力欄の下にある「そのまま開く」リンクを押すと、この機能がなかった場合とまったく同じようにセッションが開きます。呼び出しも、分析も、待ち時間もありません。
レベルを自分で決める
レールのレベルをクリックすると、それがあなたの決定になります。リクエストは一切送られず、対応するモデルでセッションがすぐに開きます。
このエージェント、このプロジェクト、またはすべてで自動に
エージェントを開くたびにこの画面を出したいですか?設定で AI Suggestion をオンにしてください。標準ではオフで、設定はまずエージェント、次にプロジェクト、最後にアプリケーションの順に解決されます。効果のあるエージェントだけに残して、ほかのエージェントはすぐに開くようにできます。
今いる場所から切る
画面が自動で開いたときは、その「なぜこの画面が出るのか?」ポップオーバーに三つのオフスイッチがあります。このエージェント、このプロジェクト、すべて。三つ先のメニューではなく、邪魔だと感じたその瞬間にオフにできます。
自動化されたエージェントはこの画面を一切見ません。QA ボット、バックログのチケット、予定されたタスク、モックアップ、チームのステップ、一時的なエージェントは、すでに指示を持っていて、その前に座っている人もいません。
Adaptive Mode の仕組み、ステップごとに
デフォルトでは、最初のメッセージの前に一度だけ実行されます。2つのオプションで、すべてのメッセージで実行し、モデルを代わりに切り替えさせることもできます。
プロンプトを書き始める
どのエージェントでも新しい会話を開き、やってほしいことを書きます。デフォルトでは Adaptive Mode は新規の会話だけを見るので、「すべてのメッセージ」をオンにしない限り、すでに進行中のセッションを中断することはありません。
タスクを読み取り、分析する
下書きが十分にまとまり、あなたが少し手を止めると、Adaptive Mode は下書きの最初の部分を、小さく高速なルーティングモデルに送り、タスクがどれくらい高い負荷かを見極めます。
モデルの提案が現れる
コンポーザーの上にチップが浮かび上がります。「Haiku に切り替え」「Sonnet に切り替え」「Opus に切り替え」のうち、最も費用対効果の高いものです。現在のモデルがすでに最良の選択なら、その旨を代わりに伝えます。
ワンクリックで適用する
チップをクリックするとモデルが適用されます。すでにセッションが動いている場合、Adaptive Mode はそれをライブで切り替えます。選択はエージェントにも保存されるので、次回の起動は適切なモデルで始まります。
あるいは再計算、あるいは却下
プロンプトを言い換えましたか。更新を押せば、新しい下書きに合わせて推奨を再計算します。今のモデルに満足していますか。チップを却下して送信してください。すべての判断はあなたが握ったままです。
「すべてのメッセージ」と「自動」、必要なら
デフォルトでは1つの会話につき一度だけ提案し、その後は静かにしています。「すべてのメッセージ」をオンにすると、その後のメッセージもひとつずつ分析され、モデルはメッセージごとに変わりえます。Claude Code、Codex、oh-my-pi では、「より適したモデルが見つかったとき」を「自動」に設定すると、メッセージが送信される前にエージェントが切り替わり、「Haiku に切り替えました」(または Sonnet、Opus)と表示され、親指のアイコンで選択を評価できます。どのモデルが応答したかを API が確認すると、チェックマークのバッジが付きます。
プロバイダーに依存しないモデルルーティング
Adaptive Mode はあなたが使っているプロバイダーのモデルラインアップを読み取り、そのカタログの中から推奨します。特定のベンダーに縛られません。
Claude
Haiku、Sonnet、Opus の間でルーティングします。Haiku は素早い修正、リネーム、翻訳、短いテスト、要約に。Sonnet はプルリクエストのレビュー、新しいエンドポイント、複雑なデバッグ、リファクタリングに。Opus はシステムアーキテクチャ、セキュリティ監査、大規模なレガシーリファクタリング、深いパフォーマンス作業に。
Codex
Codex のラインアップの中でルーティングします。小さなバグや手早い質問向けの高速で安価なミニモデルから、エンドツーエンドの機能やテスト向けのバランスの取れたデフォルト、そして複雑なシステム設計や深いコードレビュー向けのフラッグシップ推論モデルまで。
Antigravity
小さな修正、翻訳、要約向けの高速な Antigravity モデルと、機能の実装、デバッグ、より深い分析向けの高性能な Antigravity モデルの間でルーティングします。
その他のプロバイダー
どのプロバイダーでも、Adaptive Mode はシンプルなルールに立ち返ります。軽い作業には最も安いモデル、通常の作業にはバランスの取れたモデル、難しい作業には最も高性能なモデル。プロバイダーを追加すれば、そのプロバイダー自身のモデルの中でルーティングします。
FAQ
AgentsRoom の Adaptive Mode とは何ですか?
Adaptive Mode は、AIコーディングエージェントのためのスマートなモデルルーティングです。これから送ろうとしているメッセージを読み取り、プロバイダーのラインアップの中でそれでもタスクをしっかりこなせる最も費用対効果の高いモデルを提案します。軽いタスクには軽量で安価なモデルを、重いタスクにはフラッグシップを。デフォルトでは会話の最初のメッセージで実行され、オプションですべてのメッセージで実行できます。目的はシンプルで、必要としない仕事にパワフルなモデルを使って払いすぎるのをやめることです。
Adaptive Mode はどうやってモデルを選ぶのですか?
下書きの最初の部分を、どんな種類のタスクがどのモデルのティアに合うかの例で導かれた、小さく高速なルーティングモデルに送ります。そして、現在のプロバイダーが実際に提供するモデルに照らして検証したうえで、タスクに合う最も安いモデルを返します。現在のモデルがすでに最適なら、変更を押し付けるのではなく、モデルが最適だと伝えます。
これで実際どうやってお金が節約できるのですか?
同じ単純なタスクなら、安いモデルはフラッグシップのほんの一部のコストで済みます。タイポ修正、リネーム、翻訳、短いテストを最上位モデルで動かせば、必要の何倍もの速さでプランの利用予算を燃やすことになります。Adaptive Mode はその軽い作業を軽量モデルへ回すので、各タスクのコストが下がり、利用上限に達する前により多くのタスクをこなせます。1日、そして多数の並列エージェントを通じて、その節約は積み重なります。
どんなモデルを提案できますか?
あなたのプロバイダーが提供するものは何でも。Claude では Haiku、Sonnet、Opus。Codex では高速なミニモデル、バランスの取れたデフォルト、フラッグシップの推論モデルまで。Antigravity では高速なモデルと高性能なモデル。その他のプロバイダーでは、最も安い、バランスの取れた、最も高性能なモデルに立ち返ります。Adaptive Mode はモデルの一覧をリアルタイムで読み取るので、常に実際に動かせるモデルを推奨します。
モデルは自動で切り替わりますか?
そう頼んだときだけです。デフォルトでは Adaptive Mode は提案するだけで、変更はチップをワンクリックで適用します。動いているセッションはライブで切り替わり、選択はエージェントに保存されるので、次回の起動は適切なモデルで始まります。「より適したモデルが見つかったとき」を「自動」に設定すると(設定 > 最適化 > アダプティブモデル)、メッセージが送信される前にエージェントが選ばれたモデルに切り替わり、どのモデルを選んだかが表示され、親指のアイコンで選択を評価できます。メッセージが判定を待つのは最大 4 秒で、送信が止められることはありません。
提案はいつ現れますか?
デフォルトでは、新規の会話で、まとまったプロンプトを入力して少し手を止めたあとに現れます。1つの会話につき一度だけ実行されるので、進行中のセッションを中断することはありません。「すべてのメッセージ」をオンにすると、会話のその後のメッセージもひとつずつ分析されます。エージェントがまだ作業中に送ったメッセージは分析されません。切り替えは現在のターンのあとにしか適用できないからです。
提案を再計算できますか?
はい。プロンプトを書き直したら、チップの更新ボタンを押して新しい下書きに合わせて推奨を再計算してください。手動の再計算は月の提案のうち1回分を使うので、毎回のキー入力で動くことなく、必要なときに使えます。
私のプロンプトは非公開ですか?
提案を計算するために、メッセージの最初の 500 文字だけが AgentsRoom のサーバーに送られます。Adaptive Mode が有効なときだけで、デフォルトでは1つの会話につき一度、「すべてのメッセージ」がオンならメッセージごとです。自分でモデルを選びたければ、設定からこの機能を完全にオフにできます。
Adaptive Mode は Claude だけでなく Codex や Antigravity でも動きますか?
はい。Adaptive Mode はプロバイダーに依存しません。エージェントが使っているプロバイダーのモデルカタログを読み取り、それが Claude、Codex、Antigravity、あるいは他のサポート対象プロバイダーであっても、そのカタログの中から推奨します。モデル切り替えのコマンドは、あなたが使っているプロバイダー向けに作られます。クリックなしでモデルを切り替える「自動」オプションは、現時点では Claude Code、Codex、oh-my-pi で使えます。他の CLI では、代わりにチップがモデルを提案します。
Adaptive Mode のオンとオフはどう切り替えますか?
新規インストールではデフォルトでオンになっており、コンポーザーの上に表示されるお知らせから、そのまま使うかオフにするかを選べます。あとからオフにするには、AgentsRoom の設定を開き、最適化タブで Adaptive Mode のチェックを外します。同じチェックボックスで再びオンにできます。オフの間は、下書きを分析するものは何もなく、下書きに関する情報があなたのマシンから外に出ることもありません。
Adaptive Mode は Jev ルーターのように、メッセージごとにモデルを変えられますか?
はい。設定 > 最適化 > アダプティブモデル で「すべてのメッセージ」をオンにすると、最初のメッセージだけでなく、送信するメッセージがひとつずつ分析されます。「自動」も加えると、メッセージが送信される前にモデルが変わります。インストールするプラグイン、別のプロキシ、追加の API キーはありません。「自動」は現時点では Claude Code、Codex、oh-my-pi で使えます。これらのエージェントは AgentsRoom に組み込まれた小さなローカルサーバーにつながった状態で起動し、モデルはそこで再起動なしに変わります(すでに開いていたエージェントは再起動してください)。他の CLI では、代わりにチップがモデルを提案します。チップのチェックマークのバッジで、API が実際に使ったモデルを確認できます。リモート SSH ホスト上のエージェントや、すでに独自のプロキシを向いているエージェントは、CLI のモデルコマンドで切り替わるか、Codex の場合は会話の再開で切り替わります。切り替えのたびに前のモデルのプロンプトキャッシュが失われるため、新しいモデルでの最初のメッセージは履歴を通常料金で読み直します。oh-my-pi では、AgentsRoom がメッセージの直前に /switch コマンドを送信します。
Adaptive Mode が選べるモデルを指定したり、1M コンテキストを強制したりできますか?
はい。設定 > 最適化 > アダプティブモデル の「選択できるモデル」に、インストール済みの各 CLI のモデルが並びます。チェックを外したモデルは Adaptive Mode が選ばなくなります。たとえば Opus と Sonnet のみにして、Haiku は使わないといった設定です。バックログのチケットの AI 分類も同じリストに従い、CLI ごとに少なくとも 1 つのモデルはチェックされたままになります。「選ばれたモデルのコンテキスト」を「常に最大」にすると、適用されるすべてのモデルで最大のコンテキストウィンドウが使われます(対応している Claude モデルでは 1M)。同じページには、新しいチケットで分類が入力する項目(エージェント、推論の強度、種類、タグ、タイトル)もまとめられています。最初の数回、分類がチケットを変更したときは、マスコットが項目の上でそれを知らせ、これらの設定へのリンクを表示します。モデルとコンテキストの選択はアカウントに保存されるので、スマートフォンや他のコンピューターにも反映されます。
AgentsRoom の AI Suggestion とは何ですか?
AI Suggestion は、エージェントのセッションが始まる前に開く短い画面で、エージェントのカードやワークスペースのドックの上にあるバーの提案ボタンから呼び出します。タスクを一文で説明すると、一度の呼び出しが、あなたのプロバイダーのカタログの中でその仕事をこなせる最も安いモデル、セッション名、そしてエージェントを選んでいない場合は引き受けるべきエージェントを返します。セッションはその後、設定済みで開き、あなたの一文が最初のメッセージになります。設定でオンにすれば、エージェントを開くたびに自動でも表示されます。
タスクの難しさがすでに分かっている場合は?
レールのレベルをクリックしてください。それがあなたの決定になり、呼び出しは完全に省かれ、そのレベルに対応するモデルでセッションがすぐに開きます。答えがすでに分かっているとき、この画面は最も速くなります。
呼び出しが失敗したり、オフラインだったりしたらどうなりますか?
エージェントはそれでも開きます。この機能がなければ使っていたはずのモデルで開きます。ネットワークの断絶も、レート制限も、使えない応答も、すべて同じ終わり方をします。エージェントを開けなくしてしまう画面は、画面がないより悪いからです。マシンが確実にオフラインのときは、そもそも画面が表示されません。
モデルだけでなくエージェントも選べますか?
はい、エージェントを指定せずに画面を開いた場合は選べます。タスクは、すでにあなたのルームにいるエージェント、十四の標準ロール、そして専門家カタログと突き合わされます。新しいプロジェクトも今はこうします。何かを作らなければならないという理由でフルスタックのエージェントを黙って作る代わりに。
相性のよい機能
CLI Doctor
Claude Code、Codex、あるいは任意のエージェントCLIが起動時に落ちたとき、AgentsRoomはエラー、実行した正確なコマンド、すべての起動フラグの出所を読み取り、何が壊れたのかと直し方を説明します。
エージェント提案
どのAIエージェントを使用すべきか分からない?タスクを平易な言葉で説明すると、AgentsRoomが適切なエージェントを提案します:あなたの部屋から、14の組み込みロールまたは260以上のカタログ専門家から、一行の理由とともに。ワンクリックでタスクが割り当てられます。
AI モデル対応表
Claude Opus、Sonnet、Haiku に相当する Codex、Gemini、Grok のモデルはどれ?すべてのコーディングエージェント CLI を性能レベル別に並べたリアルタイムの表で、開発者が最も多く起動しているモデルもわかります。
Adaptive Mode vs Claude Code 向け Jev
jev-router や jev-route を検討中ですか。AgentsRoom のメッセージごとのルーティングとの比較と、Jev ルーターが勝っている点。
Adaptive Mode vs Codex 向け Jev
jev-codex を使っていますか。AgentsRoom がインストール不要で Codex の各メッセージをどうルーティングするか、そしてモデルが切り替わると何が変わるか。
Claude Code トークン使用量
セッションごとのトークン消費とコストをリアルタイムで確認。Adaptive Mode と好相性です。賢くルーティングして、節約が積み上がるのを見届けましょう。
エージェントの委譲
開発エージェントが MCP 経由で、より安い QA エージェントにテストを引き渡します。Adaptive Mode と同じ発想を、エージェント全体に適用したものです。
マルチプロバイダー
Claude、Codex、その他の CLI を並べて動かせます。どのモデルにも、あなたが一番よく知っているプロバイダーでの対応モデルが表示されます。
プロジェクト統計
プロジェクトごと、エージェントごとの時間、プロンプト、トークン、コスト。Adaptive Mode が守る手助けをする予算の、ダッシュボードビューです。
エージェントの状態追跡
すべてのプロジェクトにわたる各エージェントのライブ状態。誰が作業中で、誰があなたを必要としているかが常にわかります。
セッションの復元
終了して戻ってくると、すべてのエージェント、ターミナル、モデル選択が、離れたときのままです。
さらに詳しく
Claude Codeのトークンコストを削減する方法
Claude Codeはトークンごとに請求され、ほとんどの支出は目に見えません:膨張したコンテキスト、間違ったモデル、生のPDF、エージェントが同じファイルを再読すること。ここでお金が実際にどこに行くのか、そしてそれを削減する方法、請求を低く保ちながらあなたを遅くしない習慣とツールを紹介します。
Claude Codeトークン使用量を確認する方法:エージェントの支出を確認する4つの方法
Claude Codeトークン使用量を確認する4つの方法: /costコマンド、セッションのトランスクリプト、ccusage CLI、そしてライブのセッションごとのメーター。各エージェントがどれだけ支出しているかを正確に確認できます。
あなたのプロジェクトに最適なAIエージェントはどれですか?
マーケティングコピーを書くフロントエンドエージェントは静かな失敗です。すべてのタスクを適切なAIエージェントにマッチさせる方法:役割、カタログの専門家、カスタムエージェント、そして誰がその仕事を引き受けるべきか全く分からないときに何をすべきか。
必要のないAIモデルのパワーに払いすぎるのをやめよう
AgentsRoom をダウンロードし、Adaptive Mode に各タスクで最も費用対効果の高いモデルを選ばせましょう。軽い作業には軽量モデル、難しい問題にはフラッグシップ、タスクあたりに燃やす予算は少なく、1日あたりに届けるタスクは多く。
コンパニオンアプリ:外出先でもエージェントを確認
Claude、Codex、Antigravity CLI、またはその他の AI プロバイダーを使用します。
バグや要望を公開バックログに直接送信できます。