Höre auf, Prompts zu tippen.
Diktiere sie.
Das Sprachdiktat lebt direkt im Composer des Agenten. Klicke auf das Mikrofon, sprich deinen Prompt, und der transkribierte Text landet im Entwurf an deiner Cursorposition. Speech-to-Text für deine KI-Coding-Agenten, ohne separate Diktier-App, die man im Blick behalten muss, und ohne Copy-Paste zwischen zwei Fenstern.
Einen langen, präzisen Prompt zu tippen kostet Minuten. Denselben Prompt zu diktieren dauert Sekunden. Mehr Kontext für deinen Agenten, weniger Klärungs-Rückfragen, weniger verschwendete Tokens. Der Wert ist vom Code zum Prompt gewandert, und Sprachdiktat ist der schnellste Weg, einen guten zu schreiben.
Sprachdiktat in Aktion : klicke auf das Mikro, sprich den Prompt, beobachte die Live-Wellenform, und das Speech-to-Text-Transkript landet im Composer, bereit zum Bearbeiten und Senden.
Hier ist die Verschiebung, auf die das Sprachdiktat antwortet. Das Schwierige an der Arbeit mit einem KI-Coding-Agenten ist nicht mehr das Schreiben des Codes, das übernimmt der Agent. Das Schwierige ist das Schreiben des Prompts : zu beschreiben, was du willst, die Einschränkungen, die Randfälle, die Datei, die angefasst werden soll, das Verhalten, das vermieden werden muss. Ein präziser Prompt ist der Unterschied zwischen einem Treffer und zehn frustrierenden Rückfragen. Und ein präziser Prompt ist lang, also langsam zu tippen.
Das Sprachdiktat schafft die Tipp-Steuer ab. Du klickst auf den Mikrofon-Button im Composer, du sagst alles, was du getippt hättest, oft mehr, als du dir die Mühe gemacht hättest zu tippen, und die Speech-to-Text-Transkription erscheint im Entwurf. Du sprichst mit 150 Wörtern pro Minute, du tippst nicht mit 150 Wörtern pro Minute. Diktieren ist einfach schneller, und ein schnellerer Kanal bedeutet, dass du deinem Agenten pro Aufgabe mehr Kontext gibst.
Das ist kein nachträglich angeschraubtes Extra. Das Mikrofon ist Teil des AgentsRoom-Composers, direkt neben der Prompt-Bibliothek und den Zeichenwerkzeugen. Das Transkript wird an deiner Cursorposition eingefügt, sodass du Tippen und Diktieren im selben Entwurf mischen kannst. Nichts wird automatisch gesendet : der Text landet im Entwurf, du liest ihn, korrigierst das eine Wort, das das Modell falsch verstanden hat, und drückst Enter, wenn du bereit bist. Sprachdiktat ist hier eine Schreibhilfe, kein Autopilot.
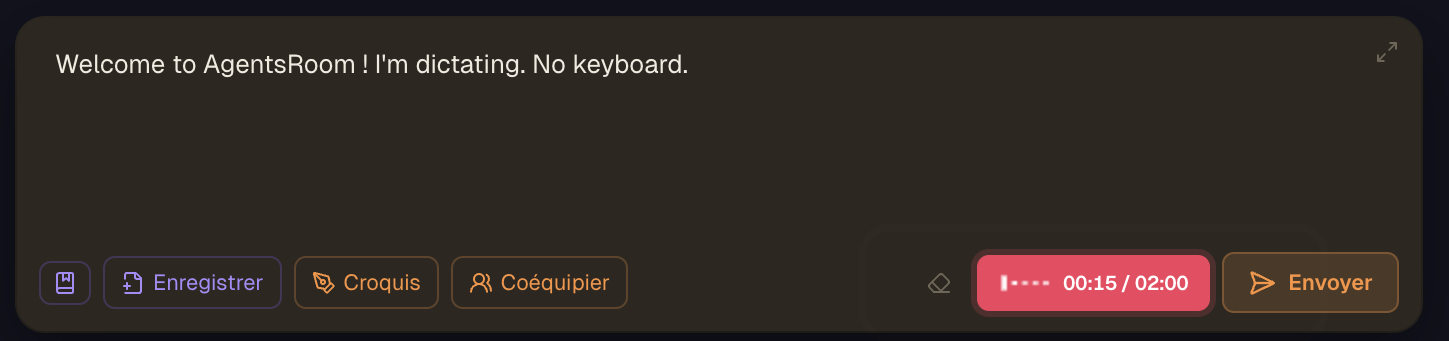
Der Mikrofon-Button sitzt in der Werkzeugleiste des Composers. Während der Aufnahme zeigt eine Live-Wellenform den Eingangspegel, dann erscheint der transkribierte Prompt im Entwurf.
Warum du deine Prompts diktierst statt sie zu tippen
Geschwindigkeit. Du sprichst um ein Vielfaches schneller, als du tippst, und du verlierst nicht den Faden, während du nach Tasten suchst. Ein Prompt von zwei Absätzen, der drei Minuten zum Tippen bräuchte, ist ein Sprachdiktat von dreißig Sekunden. Über einen ganzen Tag des Promptens deiner Agenten summiert sich diese Zeit zu echten Stunden, die du zurückbekommst.
Präzision. Weil Diktieren kaum etwas kostet, sagst du mehr. Du beschreibst den Randfall, den du übersprungen hättest, die Datei, die du nicht benannt hättest, das Verhalten, das du vermeiden willst. Ein reicherer Prompt ist ein präziserer Prompt, und ein präziserer Prompt ist genau das, was einen KI-Coding-Agenten die Aufgabe beim ersten Versuch treffen lässt.
Token-Ökonomie. Jede Klärungs-Rückfrage mit einem Agenten kostet Tokens : der Agent fragt, du antwortest, er liest den Kontext erneut. Ein präziser, vorab diktierter Prompt lässt diese Rückfragen zusammenfallen. Weniger Hin und Her bedeutet weniger verbrauchte Tokens für dasselbe Ergebnis, also eine direkte Ersparnis auf deiner KI-Coding-Rechnung.
Freihändig und mobil. Auf dem Desktop hältst du die Hände frei, während ein Agent läuft, und diktierst den nächsten Prompt laut. Auf dem Smartphone ist das Sprachdiktat mit Abstand der schnellste Weg, einen Agenten zu füttern, ohne mit einer mobilen Tastatur zu kämpfen. Sprich die Idee aus, sie landet in deinem Agenten auf dem Desktop.
So funktioniert das Sprachdiktat
Klicke auf das Mikro, sprich, prüfe, sende. Vier Schritte, keine separate App, kein Copy-Paste.
Klicke auf das Mikrofon im Composer
Setze deinen Cursor in den Composer des Agenten und klicke auf den Mikro-Button in der Werkzeugleiste. Beim ersten Mal fragt macOS nach der Mikrofon-Berechtigung, AgentsRoom leitet diese Anfrage an das System weiter, sodass du sie nur einmal erteilst.
Sprich deinen Prompt
Der Button wechselt in den Aufnahmemodus : ein pulsierender Zustand mit einer Live-Wellenform, die deinen Eingangspegel in Echtzeit anzeigt, damit du weißt, dass das Mikro auch wirklich Audio aufnimmt. Sage alles, was dein Agent wissen soll, in deiner eigenen Sprache.
Stoppe, und es wird transkribiert
Klicke erneut, um zu stoppen. Das Audio geht zur Transkription, und der Button zeigt einen Transkriptionszustand, während das Speech-to-Text läuft. Du wählst kein Modell : AgentsRoom nutzt bei einem normalen Clip sein genaues Standardmodell und wechselt ab neunzig Sekunden Aufnahme auf ein schleifenresistentes Modell, weil das genaue bei langem oder verrauschtem Audio anfängt, sich zu wiederholen.
Das Transkript landet an deinem Cursor
Der transkribierte Text wird an der Cursorposition in den Entwurf eingefügt, bei Bedarf mit einem trennenden Leerzeichen. Deine Cursorposition wird wiederhergestellt, sodass du weitertippen oder einen weiteren Abschnitt diktieren kannst. Tippen und Diktieren mischen sich frei im selben Prompt.
Prüfen und bearbeiten
Noch wird nichts gesendet. Der Prompt liegt im Entwurf. Lies ihn, korrigiere das seltene Wort, das das Modell falsch verstanden hat, füge eine Zeile per Tastatur hinzu, ordne einen Satz um. Du behältst die volle Kontrolle darüber, was dein Agent tatsächlich erhält.
Senden, wenn du bereit bist
Drücke Enter, um den Prompt an deinen Agenten zu senden, genau wie eine getippte Nachricht. Aus Sicht des Agenten ist es nur Text, also funktioniert das Sprachdiktat gleichermaßen mit Claude, Codex, GitHub Copilot CLI, Cursor und 15 weiteren Agent-CLIs.
Schnellere Prompts, weniger Tokens
Warum es günstiger ist, vorab einen besseren Prompt zu diktieren, als einen dünnen zu tippen und dann zu iterieren.
Ein dünner Prompt ist teuer auf eine Weise, die sich nicht auf der Uhr zeigt. Der Agent hat zu wenig Anhaltspunkte, also rät er, du korrigierst, er liest den ganzen Kontext erneut, du korrigierst wieder. Jede dieser Runden sind Eingabe-Tokens, Ausgabe-Tokens und Cache-Lesevorgänge. Drei Rückfragen, um ein Feature zu klären, können mehr kosten als das Feature selbst.
Das Sprachdiktat dreht die Ökonomie um. Weil Sprechen schnell ist, lädst du den Kontext vorab : die Einschränkungen, die Dateipfade, das zu vermeidende Verhalten, das Beispiel, das du im Kopf hast. Der Agent trifft es näher am ersten Versuch. Du tauschst dreißig Sekunden Diktat gegen zwei oder drei vermiedene Klärungszyklen.
Das summiert sich. Ein normaler Tag sind Dutzende Prompts. Wenn das Sprachdiktat bei einem guten Teil davon eine Rückfrage spart, stapeln sich die eingesparten Tokens über den Tag, über das Team, über den Monat. Der günstigste Token ist der, den du nie ausgeben musstest, um dich noch einmal zu erklären.
Es ist außerdem einfach weniger Reibung. Weniger Reibung bedeutet, dass du tatsächlich den längeren, besseren Prompt schreibst statt des faulen Einzeilers, den du getippt hättest, weil die vollständige Version zu viel Arbeit schien. Das Sprachdiktat macht den guten Prompt zum einfachen Prompt.
Wähle deine gesprochene Sprache
Auf dem Desktop lässt dich das Sprachdiktat die gesprochene Sprache in den Einstellungen festlegen. Das Transkriptionsmodell ist keine Einstellung : Es ergibt sich aus der Länge deiner Aufnahme.
Wie das Modell gewählt wird (Desktop)
- Kurzer Clip, bis neunzig Sekunden: das genaue Standardmodell
- Längere Aufnahme: ein schleifenresistentes Modell, das sich bei langem oder verrauschtem Audio nicht wiederholt
- Offline-Modus, wenn du ihn einschaltest: ein lokales Modell auf deinem eigenen Rechner, ohne Netz und ohne Guthaben
Gesprochene Sprachen
- Automatische Erkennung (Standard, das Modell erkennt die Sprache)
- Čeština, Slovenčina, English, Français, Español, Deutsch, Italiano, Português, Nederlands
- Русский, Українська, 中文, 日本語, 한국어
- العربية, हिन्दी, Bahasa Indonesia, Polski, Türkçe, ไทย, Tiếng Việt
Automatische Erkennung ist der Standard und bewältigt die meisten Fälle. Erzwinge eine bestimmte Sprache, wenn kurze Aufnahmen falsch erkannt werden, aber erzwinge nur die Sprache, die du tatsächlich sprichst. 21 Sprachen plus automatische Erkennung, sodass du in deinen eigenen Worten diktierst und dein Agent sauberen Text erhält.
Was das Sprachdiktat unter der Haube wirklich tut
Auf dem Desktop nimmt der Composer deine Stimme mit der Browser-API MediaRecorder auf und sendet das Audio an das Transkriptions-Backend von AgentsRoom. Die Transkription läuft serverseitig, sodass die schwere Speech-to-Text-Arbeit nicht von deinem Rechner abhängt, und das Transkript kommt als reiner Text zurück, eingefügt an deiner Cursorposition. Das Mikrofon, die Aufnahme und das Einfügen sind alle Teil desselben Composers, in dem du ohnehin schon tippst.
Auf dem Smartphone funktioniert das Sprachdiktat bewusst anders. Die Begleit-App nutzt lokale Spracherkennung, sodass das Audio dein Telefon nie verlässt. Der erkannte Text wird dann über die Ende-zu-Ende-verschlüsselte Verbindung von AgentsRoom an den Desktop weitergeleitet und in die Eingabe des Agenten gelegt, den du auf dem Desktop fokussiert hast. Halte den Mikro-Button, sprich, lass los, und der Text erscheint in deinem Desktop-Agenten.
Beide Oberflächen teilen eine Regel : das Sprachdiktat sendet niemals von selbst. Auf dem Desktop landet das Transkript im Entwurf zur Prüfung. Auf dem Smartphone wird der Text ohne Zeilenumbruch in die Eingabe des fokussierten Agenten eingefügt, sodass du selbst noch Enter drückst. Diktieren ist eine Art, den Prompt zu schreiben, keine Art, ihn blind abzufeuern.
Die Konfiguration ist provider-neutral. Die Transkription läuft auf dem Speech-to-Text-Backend, nicht auf deinem Agenten-CLI. Egal ob dein Agent auf Claude, Codex, GitHub Copilot CLI, Cursor oder einer der 15 weiteren von AgentsRoom unterstützten Agent-CLIs läuft, der diktierte Text ist nur Text im Composer, sodass sich das Sprachdiktat über jeden von AgentsRoom unterstützten Provider identisch verhält.
Wo das Sprachdiktat funktioniert
In den Desktop-Composer und den mobilen Begleiter integriert, in 21 Sprachen.
Desktop-Composer
Ein Mikrofon-Button im Composer des Agenten, auf macOS, Windows und Linux. Serverseitige Transkription, mit dem Modell, das sich aus der Länge deiner Aufnahme ergibt. Live-Wellenform der Stimme während der Aufnahme, Transkript an der Cursorposition eingefügt, frei mit Tippen mischbar. Wähle deine gesprochene Sprache in den Einstellungen. Auch per Tastatur: Cmd/Strg+Umschalt+D startet eine Aufnahme, Esc beendet sie, und wer das Start-Kürzel gedrückt hält, nutzt es als Push-to-Talk. Beide Tasten lassen sich unter Einstellungen > Tastenkürzel ändern.
Mobile Begleit-App
Auf der iOS- und Android-Begleit-App hältst du das Mikro zum Diktieren gedrückt. Die Spracherkennung läuft lokal, sodass das Audio auf dem Telefon bleibt, und der erkannte Text wird Ende-zu-Ende-verschlüsselt an den fokussierten Desktop-Agenten weitergeleitet. Der schnellste Weg, einen Agenten aus deiner Hosentasche zu füttern.
Mehrsprachig
21 gesprochene Sprachen plus automatische Erkennung: Čeština, Slovenčina, Englisch, Französisch, Spanisch, Deutsch, Italienisch, Portugiesisch, Niederländisch, Russisch, Ukrainisch, Chinesisch, Japanisch, Koreanisch, Arabisch, Hindi, Indonesisch, Polnisch, Türkisch, Thailändisch und Vietnamesisch. Diktiere in deiner Muttersprache, dein Agent erhält sauber transkribierten Text.
Prompts tippen vs sie diktieren
Gleicher Agent, gleiche Aufgabe. Andere Geschwindigkeit, anderer Kontext, andere Token-Rechnung.
Jeden Prompt tippen
- : Du tippst mit einem Bruchteil deiner Sprechgeschwindigkeit, also bleiben Prompts kurz.
- : Kurze Prompts überspringen Kontext, also rät der Agent und du korrigierst ihn.
- : Jede Korrektur ist eine weitere Rückfrage, mehr Eingabe- und Ausgabe-Tokens.
- : Eine separate Diktier-App oder das System-Diktat bedeutet Copy-Paste zwischen Fenstern.
- : Auf dem Smartphone macht die mobile Tastatur lange Prompts mühsam, also promptest du kaum noch.
Mit Sprachdiktat diktieren
- : Du sprichst den ganzen Prompt in Sekunden, also sagst du ganz natürlich mehr.
- : Mehr Kontext vorab bedeutet, dass der Agent die Aufgabe näher am ersten Versuch trifft.
- : Weniger Klärungs-Rückfragen bedeuten weniger verbrauchte Tokens für dasselbe Ergebnis.
- : Das Mikro ist im Composer, das Transkript landet im Entwurf, kein Copy-Paste.
- : Auf dem Smartphone hältst du das Mikro und der Text erscheint über das verschlüsselte Relay in deinem Desktop-Agenten.
Das Sprachdiktat ist der günstigste Weg, jeden Prompt zugleich länger, präziser und schneller zu schreiben.
Wie ein diktierter Prompt klingt
Du musst nichts davon schreiben. Du sagst es laut, das Speech-to-Text verwandelt es in den Prompt unten, und du drückst Enter. Versuche, einen so detaillierten Prompt zu tippen, und spüre, wie lange das dauert.
Ins Mikro gesprochen
Füge einen Rate Limiter zum Login-Endpoint hinzu.
Verwende ein gleitendes Fenster von fünf Versuchen pro Minute pro IP.
Gib einen 429 mit einem Retry-After-Header zurück, wenn das Limit erreicht ist.
Lass den bestehenden Erfolgs-Pfad unangetastet.
Füge einen Unit-Test für das Erreichen des Limits hinzu und einen für das Zurücksetzen nach einer Minute.
Fass den Signup-Endpoint nicht an.Was ist das Sprachdiktat in AgentsRoom ?
Warum sollte ich Prompts diktieren statt sie zu tippen ?
Welche Transkriptionsmodelle kann ich verwenden ?
Ist das nur OpenAI Whisper ?
Welche Sprachen unterstützt das Sprachdiktat ?
Wird meine Stimme an einen Server gesendet ?
Wird der Prompt automatisch gesendet, nachdem ich diktiert habe ?
Kann ich Tippen und Diktieren im selben Prompt mischen ?
Kann ich von meinem Smartphone an einen Agenten auf meinem Rechner diktieren ?
Funktioniert das Sprachdiktat mit Claude Code, Codex und Antigravity ?
Gibt es ein Tastenkürzel zum Starten und Stoppen der Diktatfunktion?
Passt gut zu
Scratchpad
Ein größerer Prompt-Editor, im Composer nur ein Ausklappen entfernt. Diktiere ein langes Briefing, verfeinere es dort und schicke es dann an deinen Agenten.
Prompt-Bibliothek
Speichere die Prompts, die du diktierst, als wiederverwendbare Vorlagen. Die Stimme schreibt den ersten Entwurf, die Bibliothek bewahrt die guten auf.
Mobile-Desktop-Sync
Die Ende-zu-Ende-verschlüsselte Verbindung, die deinen diktierten Text vom Telefon zum fokussierten Agenten auf deinem Rechner trägt.
Fernsteuerung der Agenten
Steuere deine Desktop-Agenten von deinem Smartphone aus. Diktieren ist der schnellste Weg, ihnen einen Prompt zu schicken, während du nicht an der Tastatur bist.
Multi-Provider
Lass Claude, Codex, Antigravity, OpenCode, Aider, Grok Build, Mistral Vibe und Kimi Code nebeneinander laufen. Das Sprachdiktat funktioniert auf jedem von ihnen gleich.
Sketch
Zeichne und annotiere im Composer. Kombiniere einen diktierten Prompt mit einer schnellen Skizze, um deinem Agenten Worte und ein Bild zugleich zu geben.
































Sprich mit deinen Agenten, höre auf, Prompts zu tippen
Lade AgentsRoom herunter und diktiere deine Prompts direkt in den Composer. Schneller zu schreiben, reicher an Kontext, leichter bei den Tokens. Sprachdiktat integriert in deine KI-Coding-IDE, auf dem Desktop und auf dem Smartphone.
Companion-App: Agenten auch unterwegs im Blick behalten
Nutze Claude, Codex, Antigravity CLI oder einen anderen KI-Anbieter.
Bugs und Wünsche direkt in dein öffentliches Backlog schicken.
Agenten, die du wie eine Unterhaltung liest
Jeder Agent hat eine Rolle, ein Gesicht und einen Verlauf, den du wie in einer Messaging-App liest.
