Claude Code trzyma jedno zalogowane konto naraz. Oto jak uruchomić kilka.
Praktyczny przewodnik po używaniu konta służbowego i prywatnego na tej samej maszynie: jedna zmienna środowiskowa decydująca o tym, które logowanie jest aktywne, powód, dla którego podejście oparte na shellu przestaje działać przy więcej niż dwóch terminalach, oraz sposób na przypięcie konta do projektu.
Jest taki moment, który spotyka niemal każdego, kto używa Claude Code jednocześnie do pracy i do własnych projektów. Kończysz sesję służbową, przechodzisz do projektu po godzinach i orientujesz się, że agent nadal jest zalogowany na konto opłacane przez pracodawcę. Więc się wylogowujesz, logujesz ponownie na własne konto, a pół godziny później musisz zrobić to samo w drugą stronę.
Ta pętla nie jest brakującą funkcją. Jest konsekwencją tego, gdzie Claude Code trzyma dane logowania, a kiedy już wiesz, gdzie to jest, uruchamianie kilku kont obok siebie staje się szczegółem konfiguracyjnym, a nie problemem w przepływie pracy.
Jedna zmienna środowiskowa decyduje, które konto jest aktywne
Claude Code nie ma profili. Wszystko wiąże z jednym katalogiem: metadane sesji, historię poszczególnych projektów i logowanie. W systemach Linux i Windows logowanie to plik .credentials.json w tym katalogu; w macOS to wpis w pęku kluczy, którego nazwa pochodzi od ścieżki katalogu, więc to nadal katalog decyduje, na jakim koncie pracujesz.
Tym katalogiem jest to, na co wskazuje CLAUDE_CONFIG_DIR. Jeśli nigdy tej zmiennej nie ustawisz, jest to ~/.claude.
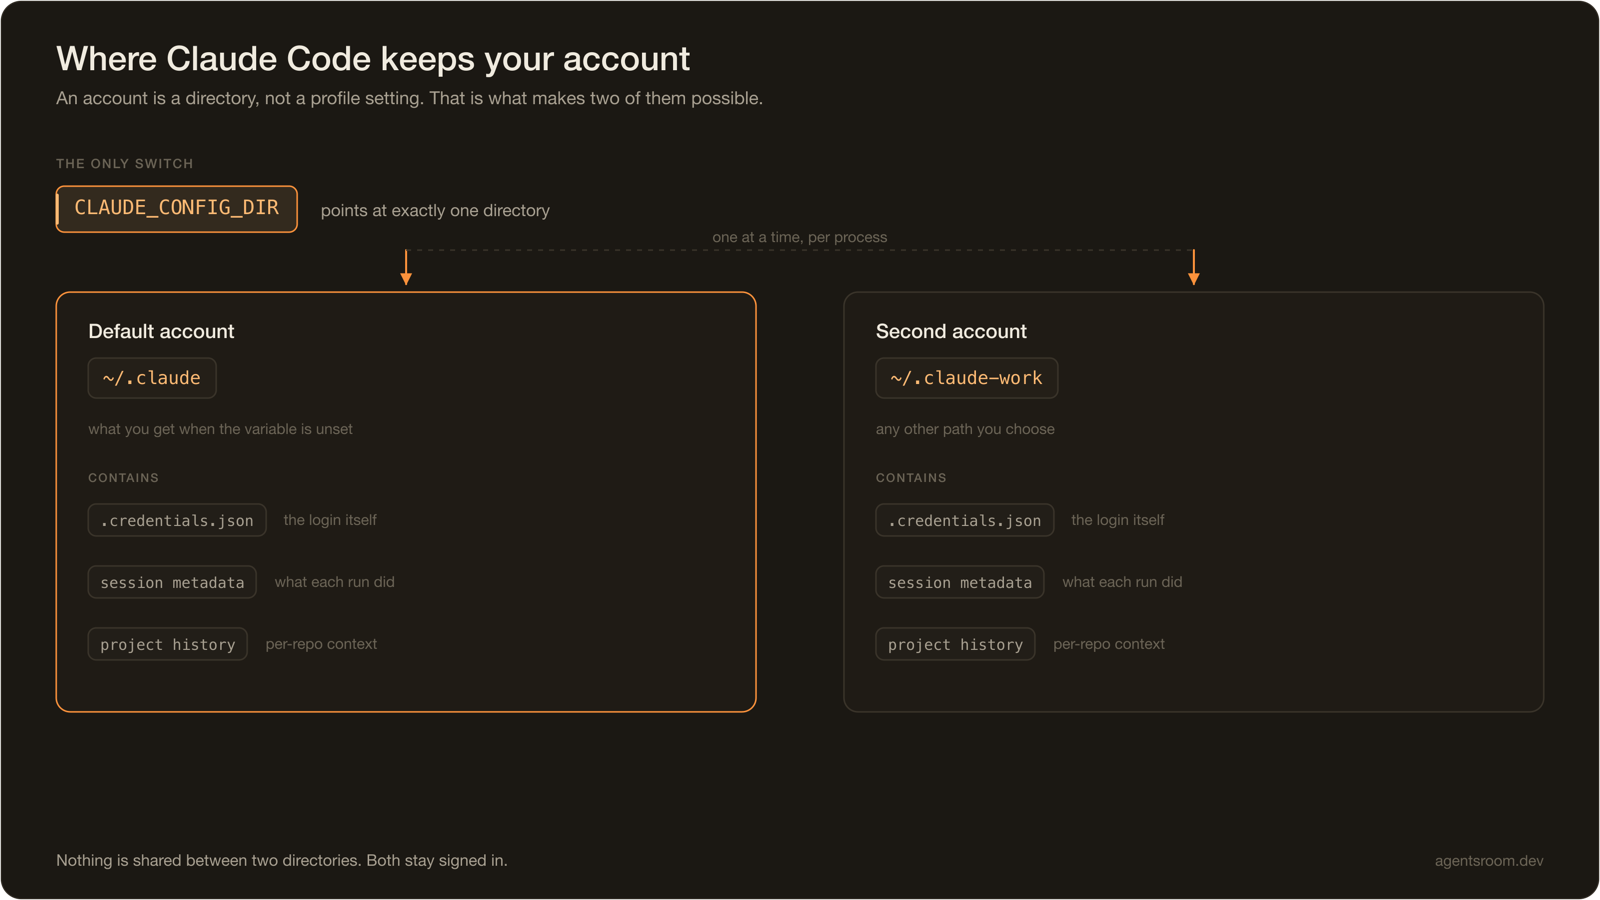
To cały mechanizm, i ma on użyteczną właściwość: skoro konto jest katalogiem, a nie ustawieniem globalnym, dwa konta oznaczają dwa katalogi. Nic nie jest między nimi współdzielone. Oba pozostają zalogowane bezterminowo i żadne nie wie o istnieniu drugiego.
Naiwna wersja więc działa:
# prywatne
CLAUDE_CONFIG_DIR=~/.claude claude

# służbowe
CLAUDE_CONFIG_DIR=~/.claude-work claude
Uruchom raz /login w tym drugim i masz dwa aktywne konta na jednej maszynie.
Gdzie podejście oparte na shellu zaczyna boleć
Powyższa dwuwierszowa wersja jest naprawdę w porządku, jeśli otwierasz jeden terminal naraz i masz dyscyplinę. Przestaje być w porządku z trzech powodów, a te się kumulują.
Zmienna działa per proces, nie per maszyna. Każdy nowy terminal, każdy nowy panel, każdy shell zintegrowany z edytorem startuje z domyślnej wartości z twojego profilu. Wyeksportuj ją w .zshrc, a jedynie przesuniesz problem: teraz to o drugim koncie będziesz stale zapominać.
Nic na ekranie nie mówi ci, które konto jest aktywne. Claude Code nie wypisuje konta w swoim prompcie. Możesz o to zapytać poleceniem claude auth status --text (wypisuje metodę logowania, organizację i adres e-mail dla katalogu, na który wskazuje bieżący shell), ale nikt nie uruchamia go przed każdym promptem. Jeśli masz otwarte dwa terminale i jeden z nich działa na koncie służbowym, wyglądają identycznie. Moment, w którym to zauważasz, to zwykle moment, w którym sprawdzasz rachunek.
To nie przetrwa zrównoleglenia. Ciekawe konfiguracje uruchamiają kilka agentów naraz, na kilku projektach. Powyżej dwóch równoległych sesji pamiętanie, który panel wystartował z którą zmienną, przestaje być kwestią dyscypliny, a staje się kwestią projektu rozwiązania.
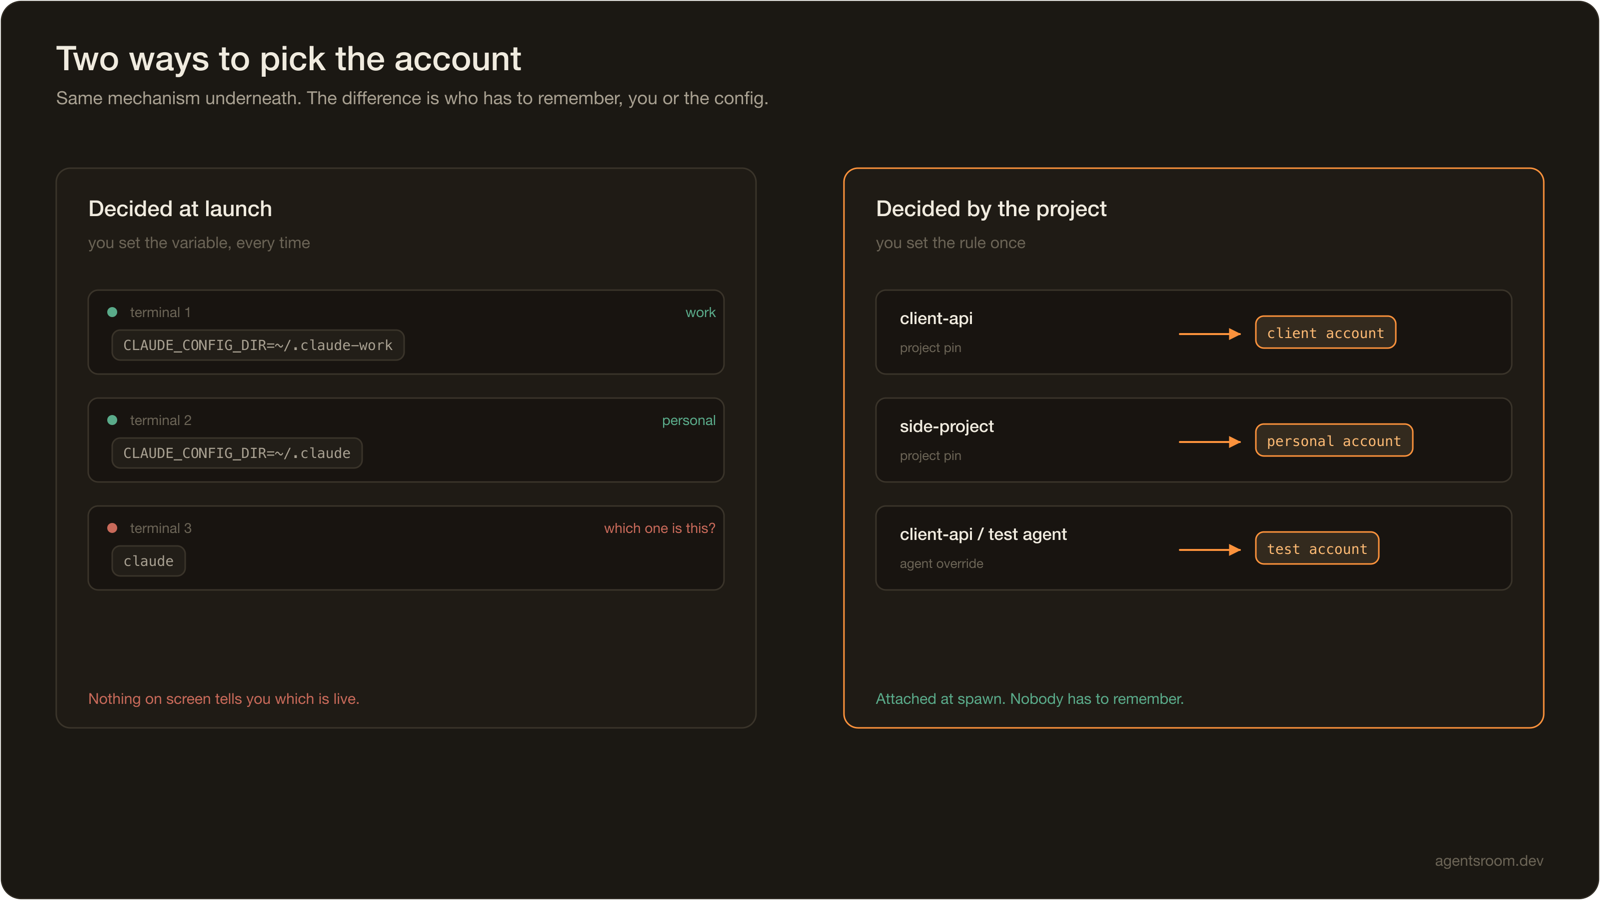
Rozwiązaniem nie jest więcej shella. Rozwiązaniem jest przestać podejmować decyzję w chwili uruchomienia i zacząć przypinać konto do tego, co naprawdę o nim decyduje: do projektu.
Przypnij konto do projektu, a nie do terminala
Zwykle chcesz reguły, a nie polecenia. Czegoś w rodzaju: repozytorium tego klienta zawsze działa na koncie tego klienta. Gdy taka reguła istnieje, nikt nie musi niczego pamiętać.
Zrobienie tego porządnie oznacza ustalanie konta w zdefiniowanej kolejności, bo reguła potrzebuje wyjątków. Wartość domyślna dla całego projektu jest trafna w większości przypadków, ale jeden konkretny agent może potrzebować działać gdzie indziej: jednorazowy eksperyment na koncie testowym albo agent przeglądający kod na licencji z większym limitem.
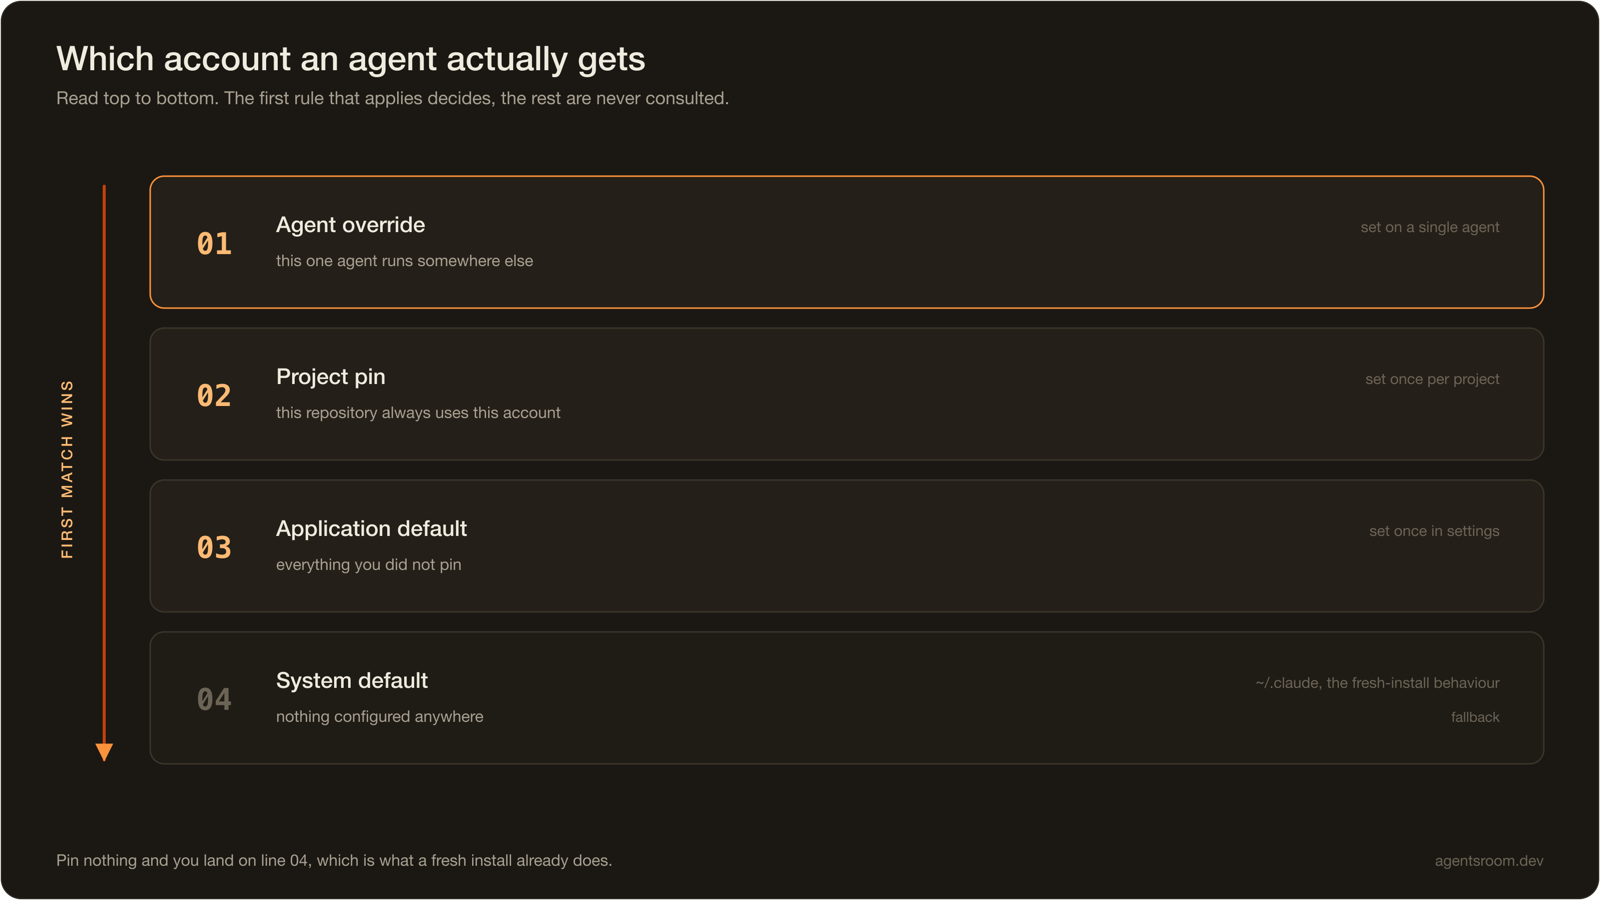
Czytając od góry, wygrywa pierwsza pasująca reguła. Nadpisanie na poziomie agenta bije konto przypięte do projektu. Konto przypięte do projektu bije to, co ustawiłeś jako ogólną wartość domyślną. Jeśli nigdzie nic nie jest skonfigurowane, lądujesz w ~/.claude, czyli tam, gdzie i tak trafia świeża instalacja. To ostatnie zabezpieczenie ma znaczenie: oznacza, że dodanie tego do istniejącej konfiguracji niczego nie zmienia, dopóki czegoś świadomie nie przypniesz.
To model, który wdraża AgentsRoom. Każde konto jest zarządzanym katalogiem, logowanie odbywa się w aplikacji, a nie w shellu, a powyższe ustalanie wykonuje się w chwili uruchomienia agenta, ustawiając CLAUDE_CONFIG_DIR wyłącznie dla tego procesu. Jeśli używasz już zewnętrznego przełącznika, takiego jak CCS, możesz podpiąć konto pod istniejący katalog profilu zamiast logować się ponownie.
Ten sam problem występuje w Codex, tylko z inną zmienną
Jeśli korzystasz z więcej niż jednego dostawcy, natkniesz się na to dwa razy. Kształt problemu jest identyczny, zmienna już nie, więc przełącznik zbudowany pod jednego dostawcę nie obsłuży drugiego. Stronę Codex dokumentujemy osobno w wielu kontach dla Codex, łącznie z tym, co różni się w procesie logowania.
Ogólny wniosek warto powiedzieć raz: izolacja kont jest mechanizmem właściwym dla konkretnego dostawcy. Każde narzędzie, które twierdzi, że obsługuje ją globalnie, albo opakowuje każdego dostawcę z osobna, albo wspiera tylko jednego.
Wiedz, które konto naprawdę spala tokeny
Rozdzielenie kont to tylko połowa powodu, dla którego ludzie to robią. Druga połowa to wiedza o tym, gdzie ląduje zużycie, zwłaszcza gdy płaci klient.
To właśnie ta część po cichu psuje się przy podejściu opartym na shellu. Narzędzia odczytujące zużycie, które zaglądają wyłącznie do ~/.claude, zaniżą wynik w chwili, gdy agent zacznie działać gdzie indziej, a liczby wyglądają na tyle wiarygodnie, że przez tygodnie nikt tego nie zauważa. Narzędzie świadome istnienia wielu kont musi przejść po każdym skonfigurowanym katalogu, nie tylko po domyślnym.
Jeśli chcesz liczb w rozbiciu na konta i sesje, stronę pomiarową opisaliśmy w jak sprawdzić zużycie tokenów Claude Code, a podgląd na żywo znajdziesz na stronie zużycia tokenów.
Do czego to nie służy
Jedno wyjaśnienie, bo to pytanie się pojawia i zasługuje na prostą odpowiedź, a nie na milczenie.
Wszystko powyżej dotyczy rozdzielania kont, które już legalnie istnieją. Licencja opłacana przez pracodawcę i prywatna subskrypcja, za którą płacisz sam, to dwie różne relacje handlowe, a trzymanie ich na jednej maszynie bez wzajemnego zanieczyszczania to realna, całkiem zwyczajna potrzeba. Tak samo jak fakturowanie klientowi zużytych przez niego tokenów czy trzymanie konta eksperymentalnego z dala od produkcyjnego.
Zakładanie dodatkowych kont po to, żeby obejść limity przepustowości posiadanego planu, to zupełnie co innego i to właśnie w to celują zasady korzystania. Opisany tu mechanizm nie czyni tego dopuszczalnym, a narzędzie, które by to automatyzowało, pomagałoby ci złamać umowę, którą podpisałeś. Jeśli twoje drugie konto istnieje dlatego, że płaci za nie ktoś inny, stoisz na pewnym gruncie. Jeśli istnieje po to, żeby zresetować limit, nie stoisz. Punktem odniesienia są zasady korzystania Anthropic, a nie ten artykuł.
Pytania, które ludzie naprawdę zadają
Czy mogę używać dwóch kont Claude Code na tym samym komputerze?
Tak. Claude Code wiąże swoje logowanie, metadane sesji i historię projektów z katalogiem wskazywanym przez CLAUDE_CONFIG_DIR, który domyślnie wskazuje na ~/.claude. Ustaw tę zmienną na drugi katalog, zaloguj się tam i masz dwa niezależne konta na jednej maszynie. Nic nie jest współdzielone między tymi katalogami, więc oba pozostają zalogowane w tym samym czasie.
Jak przełączać konta Claude Code bez wylogowywania się?
W ogóle się nie wylogowujesz. Wylogowanie i ponowne zalogowanie używa tego samego katalogu, więc tracisz pierwszą sesję, żeby zyskać drugą. Zamiast tego dajesz każdemu kontu własny katalog konfiguracyjny i wybierasz między nimi, ustawiając CLAUDE_CONFIG_DIR przy uruchamianiu CLI. Oba zestawy danych logowania pozostają ważne na dysku, a przełączanie nic nie kosztuje.
Gdzie Claude Code przechowuje dane logowania?
To zależy od systemu, ale zawsze jest to powiązane z katalogiem wskazywanym przez CLAUDE_CONFIG_DIR, czyli z ~/.claude, o ile tego nie zmienisz. W systemach Linux i Windows dane logowania trafiają do pliku .credentials.json w tym katalogu, obok metadanych sesji i historii poszczególnych projektów. W macOS trafiają zamiast tego do pęku kluczy logowania, do wpisu nazwanego od tego katalogu: Claude Code-credentials dla ~/.claude, Claude Code-credentials- z ośmioma znakami szesnastkowymi na końcu dla każdego innego katalogu. Tak czy inaczej, jeden katalog to jedno konto, i właśnie dlatego jego podmiana jest czystym przełączeniem, a nie obejściem.
Czy dwa agenty mogą działać jednocześnie na dwóch różnych kontach Claude?
Tak, o ile każdy proces agenta dostaje w swoim środowisku własną wartość CLAUDE_CONFIG_DIR. Zmienna jest odczytywana per proces przy uruchomieniu, a nie globalnie, więc dwa agenty wystartowane z dwiema różnymi wartościami działają równolegle na dwóch różnych kontach. To właśnie dzięki temu projekt służbowy i projekt prywatny da się obsługiwać w tym samym oknie.
Jak sprawdzić, na jakie konto jest zalogowany Claude Code?
Uruchom claude auth status --text w terminalu. Polecenie wypisuje metodę logowania, organizację i adres e-mail konta dla katalogu, na który w tym shellu wskazuje CLAUDE_CONFIG_DIR (sprawdzone na Claude Code 2.1.299; bez --text te same informacje wychodzą jako JSON, dodatkowo z planem i katalogiem konfiguracyjnym). Żeby sprawdzić drugie konto, poprzedź polecenie zmienną: CLAUDE_CONFIG_DIR=~/.claude-work claude auth status --text. Jeśli odpowiada Not logged in, nikt jeszcze nie zalogował się w tym katalogu albo konto zostało w nim wylogowane.
Czy posiadanie więcej niż jednego konta Claude jest niezgodne z regulaminem Anthropic?
Posiadanie osobnych kont do osobnych celów jest czymś zwyczajnym: licencja opłacana przez pracodawcę i prywatna subskrypcja, za którą płacisz sam, to dwie różne relacje handlowe. Zasady korzystania celują w co innego: w zakładanie kont po to, żeby obejść limity przepustowości posiadanego planu. Jeśli twoje drugie konto istnieje dlatego, że płaci za nie ktoś inny, stoisz na pewnym gruncie. Jeśli istnieje po to, żeby zresetować limit, nie stoisz. Punktem odniesienia są zasady korzystania Anthropic.
Wersja skrócona
Claude Code przechowuje konto jako katalog, a CLAUDE_CONFIG_DIR decyduje, które z nich jest aktywne. Dwa katalogi oznaczają dwa konta, stale zalogowane i niedzielące ze sobą niczego.
Wersja oparta na shellu działa, dopóki nie masz otwartego więcej niż jednego terminala. Później chcesz już, żeby konto było właściwością projektu, z nadpisaniem na poziomie agenta dla wyjątków, tak aby właściwe dane logowania podpinały się w chwili uruchomienia agenta i nikt nie musiał niczego pamiętać.
































Pobierz AgentsRoom
Uruchamiaj wszystkich swoich agentów AI, we wszystkich projektach, z jednego okna.
Aplikacja towarzysząca: monitoruj agentów w podróży
Użyj Claude, Codex, Antigravity CLI lub innego dostawcy AI.
Wysyłaj bugi i prośby bezpośrednio do swojego publicznego backlogu.
Agenci, których czytasz jak rozmowę
Każdy agent ma rolę, twarz i wątek, który czytasz jak komunikator.

Czytaj dalej
Wiele kont w aplikacji Claude: desktop, telefon i łączenie kont
Aplikacja desktopowa Claude trzyma zalogowane jedno konto naraz, aplikacje na iPhone'a i Androida mogą teraz trzymać do trzech, a dwóch prywatnych kont Claude nie da się połączyć. Co działa w październiku 2026, obejście przez profile przeglądarki i kiedy tak naprawdę potrzebujesz Claude Code.
Czytaj artykułJedno konto Claude na dwóch komputerach albo dla dwóch osób: co działa
Na jedno konto Claude możesz się zalogować na każdym swoim urządzeniu, a wszystkie korzystają z tych samych limitów 5-godzinnego i tygodniowego, Claude i Claude Code razem. Dwie osoby na jednym koncie to naruszenie warunków Anthropic, a planu rodzinnego nie ma. Co sprawdziliśmy 25 października 2026 i jak zobaczyć, który komputer zużył ile.
Czytaj artykułTablica feedbacku dla agentów AI: niech prompt napiszą twoi użytkownicy
Narzędzia do feedbacku zbierają zgłoszenia. Żadne nie potrafi ich zbudować. Kiedy tablica, na której piszą twoi użytkownicy, jest tą samą tablicą, z której wykonują twoje agenty kodujące, etap przepisywania po prostu znika.
Czytaj artykuł