Defina o esforço de raciocínio uma vez,
cada agente dessa CLI inicia com ele
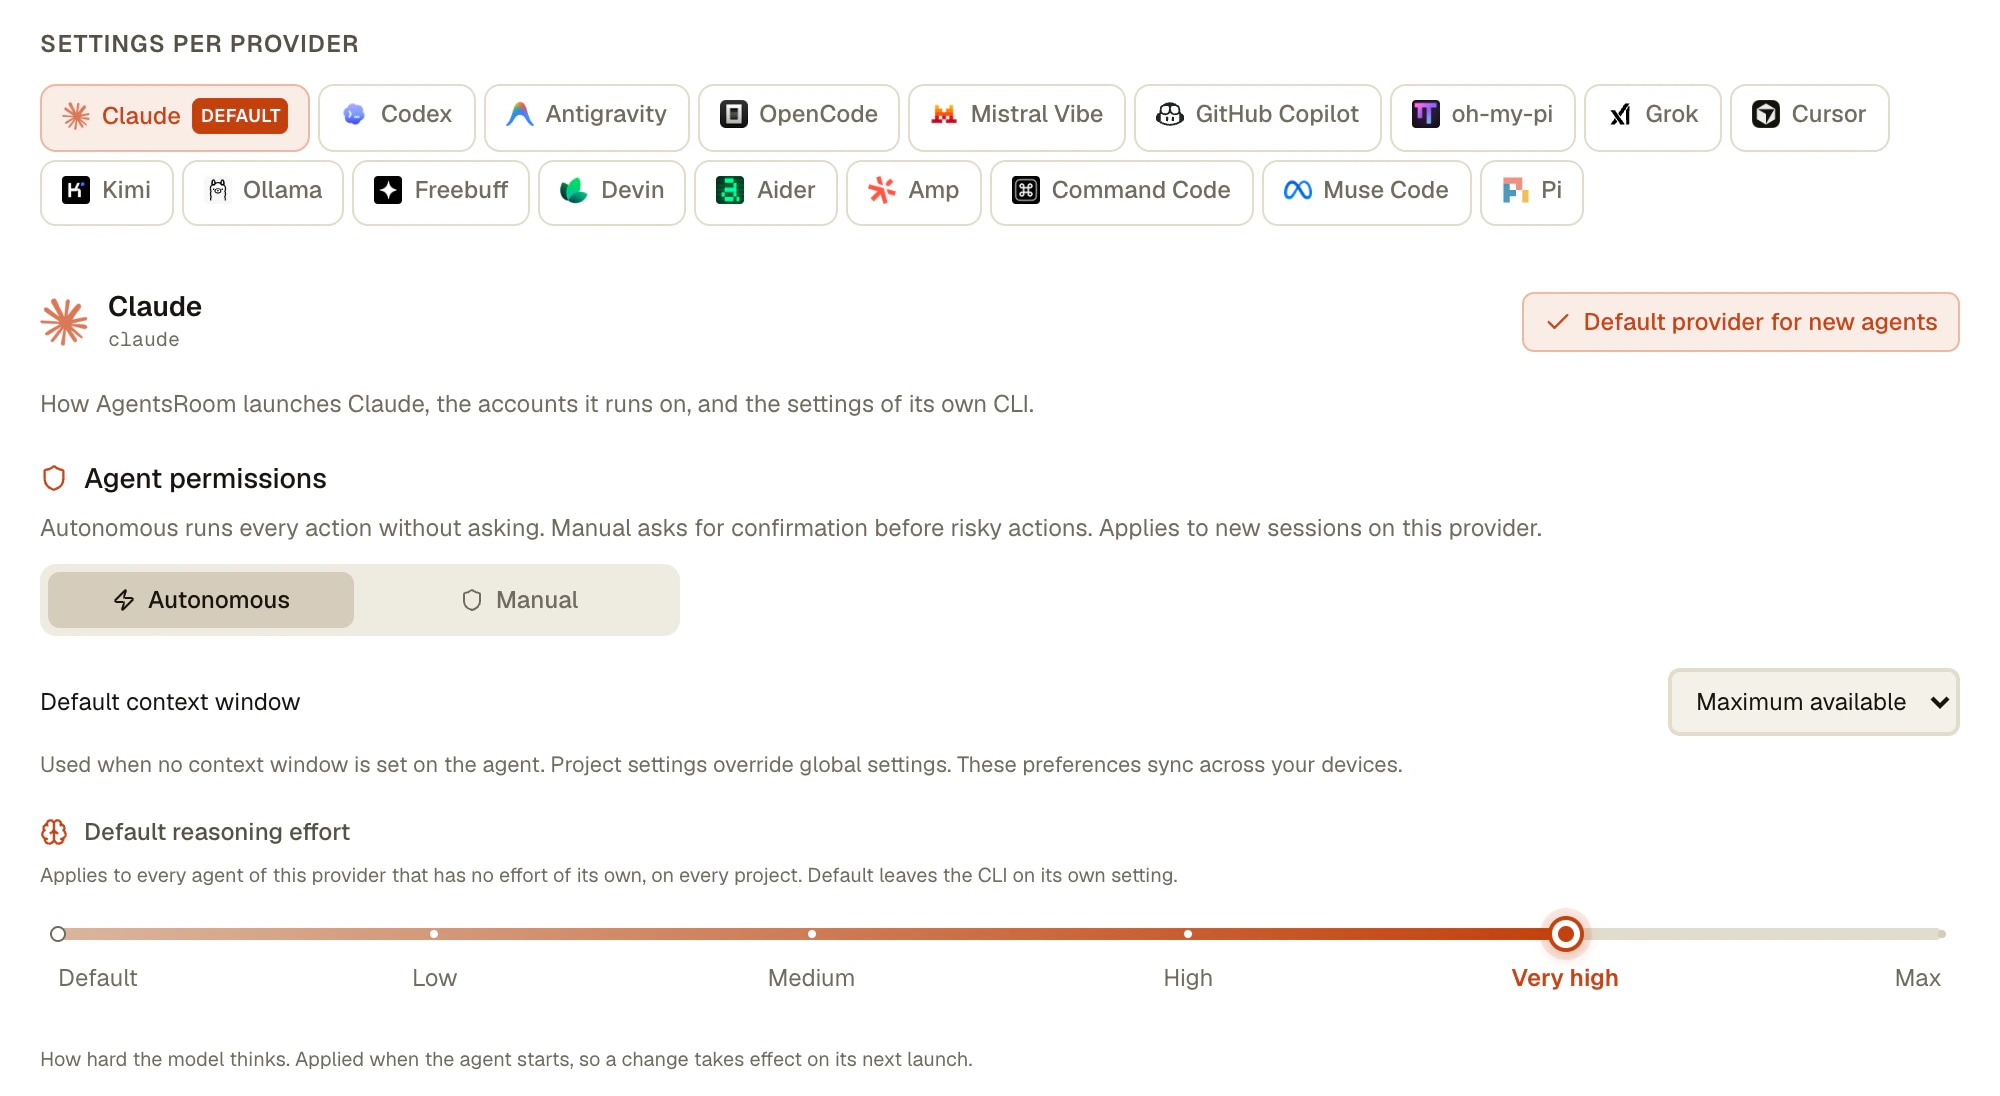
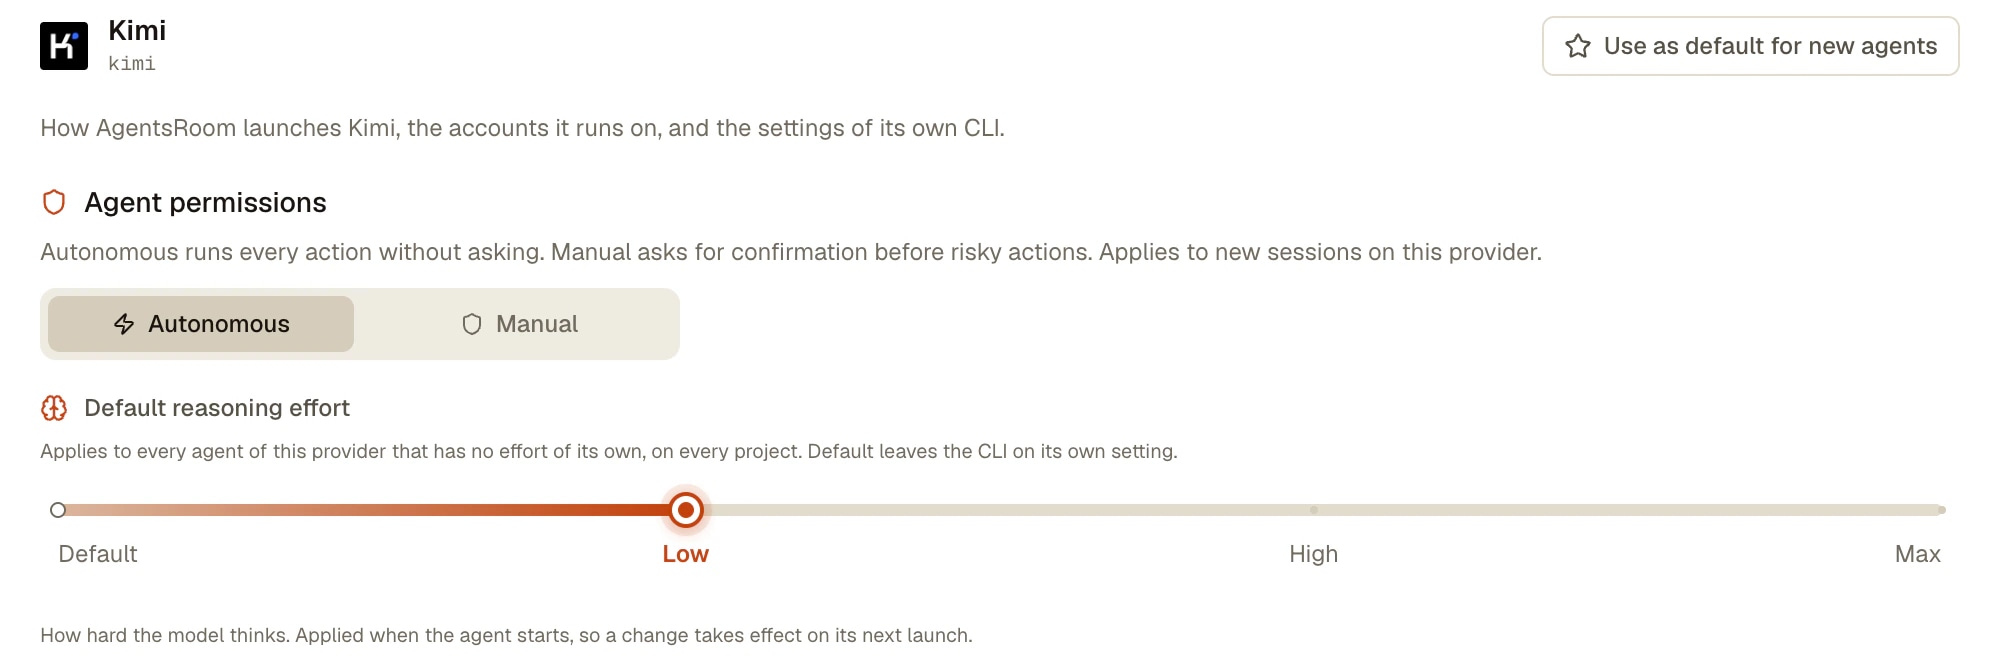
Claude Code em xhigh, Codex em high, Kimi Code em low para controlar os custos: escolha um esforço de raciocínio padrão para cada CLI em Configurações > Fornecedores de IA, e cada agente que não tem esforço próprio inicia nesse nível.
Nove CLIs expõem uma alavanca de esforço no AgentsRoom: Claude Code, Codex, Grok Build, Antigravity CLI, Kimi Code, Command Code, Muse Code, oh-my-pi e Pi. Um projeto pode usar o próprio padrão, um agente ou um ticket pode fixar o próprio nível, e o AgentsRoom passa o flag certo para cada CLI.
claude --effort xhigh-c model_reasoning_effort=highKIMI_MODEL_THINKING_EFFORT=low- Agente ou ticket
- Projeto
- Configurações
- Padrão da CLI
Um padrão por CLI, usado por cada agente que não tem esforço próprio. O primeiro nível encontrado vence.
O esforço de raciocínio é o quanto o modelo pensa antes de responder. Mais esforço costuma dar planos melhores em problemas difíceis, e custa mais tempo e mais da sua cota a cada turno. Cada CLI tem a própria alavanca para isso: o Claude Code recebe --effort na inicialização, o Codex lê model_reasoning_effort, o Kimi Code lê uma variável de ambiente, o Grok Build e o Muse Code recebem --reasoning-effort.
Definir agente por agente funciona até você rodar vinte agentes em cinco projetos. O esforço de raciocínio padrão serve para isso: um nível por CLI em Configurações > Fornecedores de IA, usado por cada agente dessa CLI que não tem esforço próprio, em todos os projetos. Um projeto pode sobrescrevê-lo em Configurações do projeto > Fornecedores de IA.
O nível nunca é gravado nos agentes. Mude o padrão e cada agente que depende dele inicia no novo nível no próximo lançamento; um agente, um ticket ou uma substituição no lançamento que fixa o próprio esforço o mantém. A configuração veio de um usuário que queria todos os agentes Kimi dele em low para manter os custos sob controle sem editá-los um por um.
O que o esforço padrão faz
Um nível por CLI
Configurações > Fornecedores de IA > a aba da CLI > Esforço de raciocínio padrão. Claude Code, Codex e as outras mantêm cada uma o próprio padrão, porque os níveis e os custos delas são diferentes.
Um projeto pode ser diferente
Configurações do projeto > Fornecedores de IA tem uma linha por CLI com alavanca. Padrão segue a configuração global; um nível escolhido ali só vale para os agentes deste projeto.
Os agentes herdam, não guardam nada
Um agente sem esforço próprio lê o padrão ao iniciar. As janelas Adicionar agente e Editar agente mostram o nível herdado no chip Padrão.
Um esforço fixado continua vencendo
O esforço próprio de um agente, um ticket do backlog, uma etapa de equipe, uma tarefa agendada ou uma substituição temporária no lançamento mantém o seu nível. Um --effort que você digitou nas opções de uma CLI também vence: o AgentsRoom não adiciona um segundo.
Limitado ao modelo
Um nível que o modelo iniciado não oferece não é forçado: o agente inicia no padrão da própria CLI. O modelo HighSpeed do Kimi Code não tem nenhuma alavanca de esforço.
Os agentes também podem definir
Os mesmos padrões podem ser lidos e gravados via MCP com settings_set e a chave reasoningEffortDefaults, para todos os projetos ou para um só, então um agente assistente pode ajustá-los para você.
Como definir um esforço de raciocínio padrão
Quatro passos, os mesmos no macOS, Windows e Linux.
- 1
Abra Configurações > Fornecedores de IA
Pelo botão ao lado da engrenagem de Configurações no rodapé, ou pela janela de Configurações. Escolha a aba da CLI, por exemplo Claude Code ou Codex.
- 2
Escolha o Esforço de raciocínio padrão dela
O campo só lista os níveis que essa CLI aceita: Baixo, Médio, Alto, Muito alto e Máx para o Claude Code, mais Ultra nos modelos Codex que o oferecem. Padrão mantém a CLI na própria configuração.
- 3
Sobrescreva para um projeto, se precisar
Configurações do projeto > Fornecedores de IA tem uma linha por CLI. Deixe em Padrão para seguir a configuração global, ou escolha um nível só para este projeto.
- 4
Inicie ou reinicie seus agentes
O esforço é aplicado quando um agente inicia, então um agente em execução pega o novo nível no próximo lançamento. Os agentes iniciados pelo celular rodam no computador e também herdam o padrão.
O que o AgentsRoom passa para cada CLI
Lido no código do AgentsRoom em 27 de outubro de 2026. Os níveis são os valores que cada CLI aceita; o app os mostra como Baixo, Médio, Alto, Muito alto, Máx e Ultra.
| CLI | Níveis | Como o nível chega à CLI |
|---|---|---|
| Claude Code | low, medium, high, xhigh, max | claude --effort <level> |
| Codex | low, medium, high, xhigh, maxultra nos modelos que o oferecem | codex -c model_reasoning_effort=<level> |
| Grok Build | low, medium, high, xhigh, max | grok --reasoning-effort <level> |
| Antigravity CLI | low, medium, high, max | --effort <level> |
| Kimi Code | low, high, maxnenhum no modelo HighSpeed | KIMI_MODEL_THINKING_EFFORT=<level> |
| Command Code | low, medium, high, xhigh, max | --effort <level> |
| Muse Code | low, medium, high, xhigh, max, ultra | muse --reasoning-effort <level> |
| oh-my-pi | low, medium, high, xhigh, max | --thinking <level> |
| Pi | low, medium, high, xhigh, max | --thinking <level> |
As outras CLIs que o AgentsRoom executa (GitHub Copilot CLI, Cursor, OpenCode, Aider, Mistral Vibe, Amp, Freebuff e Devin) não têm alavanca de esforço no AgentsRoom: mantêm o próprio comportamento e o campo não aparece para elas.
Limites
- O padrão é lido quando um agente inicia. Mudá-lo não afeta um agente que já está em execução: o novo nível vale a partir do próximo lançamento.
- Oito CLIs não têm alavanca de esforço no AgentsRoom (GitHub Copilot CLI, Cursor, OpenCode, Aider, Mistral Vibe, Amp, Freebuff e Devin), então não há padrão a definir para elas.
- Os padrões são definidos no computador: o celular não tem tela de configurações de Fornecedores de IA. Os agentes iniciados pelo celular herdam os padrões mesmo assim, porque rodam no computador.
- Um nível que o modelo não tem é descartado, não trocado pelo mais próximo: o agente roda no padrão da própria CLI.
- O esforço é a alavanca da própria CLI, não um orçamento de tokens imposto pelo AgentsRoom. O que um nível custa em tempo e em cota depende da CLI, do modelo e da tarefa.
Perguntas
Como defino um esforço de raciocínio padrão para o Claude Code?
No AgentsRoom, abra Configurações > Fornecedores de IA > Claude Code e escolha um Esforço de raciocínio padrão: cada agente Claude Code que não tem esforço próprio passa a iniciar com claude --effort e esse nível (low, medium, high, xhigh ou max). Sozinho, o Claude Code recebe --effort na inicialização e o comando /effort dentro de uma sessão; o AgentsRoom usa o flag de inicialização, então o nível é o mesmo em cada agente que ele inicia.
Como defino o esforço de raciocínio do Codex?
O Codex lê model_reasoning_effort da sua configuração. O AgentsRoom passa esse valor na inicialização como -c model_reasoning_effort seguido do nível (por exemplo -c model_reasoning_effort=high), tirado do esforço próprio do agente, do padrão do projeto ou do padrão global, nessa ordem. Os níveis vão de low a max, mais ultra nos modelos Codex que o oferecem; um nível que o modelo não tem não é enviado.
O que vem primeiro: o esforço do agente, o padrão do projeto ou o padrão global?
Primeiro o esforço próprio do agente (um ticket do backlog, uma etapa de equipe, uma tarefa agendada ou uma substituição temporária no lançamento contam como tal), depois o padrão do projeto, depois o padrão global, depois o padrão da própria CLI. O primeiro nível encontrado é o usado.
Mudar o padrão reinicia meus agentes em execução?
Não. O esforço é lido quando um agente inicia. Um agente em execução mantém o seu nível até o próximo lançamento, e então pega o novo padrão se não tiver esforço próprio.
Quais CLIs aceitam um esforço de raciocínio padrão?
Nove, as que têm uma alavanca de esforço: Claude Code, Codex, Grok Build, Antigravity CLI, Kimi Code, Command Code, Muse Code, oh-my-pi e Pi. O campo só aparece para elas, com os níveis que cada uma aceita: o Kimi Code oferece low, high e max, o Antigravity CLI low, medium, high e max.
Posso ver quais níveis de esforço outros desenvolvedores usam?
Sim, na página pública de uso dos LLM do agentsroom.dev: ela divide os agentes que os usuários do AgentsRoom iniciam por CLI, modelo e esforço de raciocínio, atualizada a cada dez minutos. Só contam os usuários que mantêm "Compartilhar dados de uso" ativado, e nenhum prompt, projeto ou arquivo é registrado.
Um esforço menor economiza minha cota do Claude ou do Codex?
Normalmente sim, porque o modelo escreve menos tokens de raciocínio por turno, mas não há um número fixo: a economia depende da CLI, do modelo e da tarefa. O usuário que pediu essa configuração colocou todos os agentes Kimi dele em low por esse motivo. Para ver o efeito nas suas próprias sessões, o contador de tokens e as barras de uso do AgentsRoom mostram quanto cada uma gasta.
Combina bem com
Adaptive Mode: um modelo para cada mensagem
O Adaptive Mode lê o seu prompt e sugere o modelo de IA mais econômico para a tarefa antes de você enviar. Modelos leves como o Claude Haiku para correções rápidas e traduções, modelos flagship como o Claude Opus para grandes refatorações e arquitetura. Gaste menos por tarefa, execute mais tarefas por dia. Funciona com Claude, Codex e Antigravity.
Multi-Provider
AgentsRoom suporta 17 provedores de codificação IA: Claude, Codex, GitHub Copilot CLI, OpenCode, Antigravity CLI, Aider, Grok Build, Mistral Vibe, Kimi Code, Amp, oh-my-pi, Freebuff, Devin, Cursor, Command Code, Muse Code e Pi. Atribua um provedor diferente por agente, troque de provedor durante a conversa e mantenha todo o contexto com handoff automático. A melhor ferramenta de codificação IA multi-provider.
Uso de tokens: por sessão: ao vivo
Medidor de tokens ao vivo em cada sessão do Claude Code no AgentsRoom. Alerta vermelho de consumo excessivo, taxa de acerto de cache, detalhamento completo de entrada, saída e cache. 100% local. Grátis no macOS, Windows e Linux.
Alertas de uso
Uma notificação de desktop ou um push no seu celular quando uma barra de cota do Claude Code, Codex, Grok, GitHub Copilot CLI, Kimi, Cursor, Antigravity, OpenCode Go, Z.AI Coding Plan, Command Code ou Muse Code cruza 50%, 75% e depois 90%, ou os limiares que você escolhe para cada barra. Um aviso por janela, enviado antes de o limite ser atingido.
Escolha o esforço uma vez, cada agente segue
Grátis no macOS, Windows e Linux.
App complementar: acompanhe seus agentes em qualquer lugar
Use Claude, Codex, Antigravity CLI ou outro provedor de IA.
Envie bugs e pedidos direto para o seu backlog público.