Meu treinador de corrida é um repositório Git e um agente Claude
Termino o treino, meu relógio sincroniza e três minutos depois a análise está escrita no meu repositório, a semana foi reajustada e meu treinador deixou um comentário embaixo da atividade no Strava. Nenhum app desenvolvido, nenhum servidor escrito, nenhuma fatura de API por token: uma assinatura Claude, o AgentsRoom e arquivos Markdown. Aqui está a montagem completa, reprodutível.
Termino meu treino. Meu relógio sincroniza sozinho com o Strava, como sempre. Vou tomar banho.
Quando saio, três coisas aconteceram sem eu tocar em nada. A análise do treino está escrita no meu repositório de treinamento. A semana foi reajustada, com o motivo da mudança anotado ao lado. E embaixo da atividade no Strava tem um comentário do meu treinador, dizendo quanto valeu o treino e o que isso muda para a sexta.
Esse treinador não é um aplicativo que eu desenvolvi. É um repositório Git de arquivos Markdown, uma assinatura Claude e o AgentsRoom segurando tudo junto. Nenhum servidor escrito, nenhuma fatura por token, mais ou menos um fim de semana de montagem.
Tudo está publicado como modelo: github.com/AgentsRoomDev/running-performance-coach. Você pode cloná-lo e torná-lo seu preenchendo os espaços deixados em branco. Este artigo explica como ele funciona, peça por peça, partindo do princípio de que você já ouviu a palavra "API" mas nunca escreveu um webhook.
Para situar: corro há muito tempo, 2h47 na maratona, 1h13:59 na meia, 33:45 nos 10 km. O objetivo do ciclo atual é voltar a baixar de 34 minutos nos 10 km. Isso importa para o que vem: um treinador genérico que me reexplica o que é um treino de limiar não me serve de nada, e esse é exatamente o problema que essa montagem resolve.
O que acontece entre o fim do meu treino e o comentário
A cadeia completa tem seis etapas:
- Meu relógio envia a atividade para o Strava. Essa parte já acontece para todo mundo.
- A cada 15 minutos, um pequeno script Python pergunta ao Strava se tem novidade.
- Quando encontra um treino novo, ele fabrica uma ficha de treino em Markdown no meu repositório: voltas, parciais, volume, frequência cardíaca. Só dados medidos.
- Ele também reescreve o título e a descrição da atividade no Strava, para o meu feed parar de exibir "Corrida à tarde".
- Depois envia uma mensagem assinada para o AgentsRoom, que abre um agente Claude com o treino já na mão.
- Esse agente faz o trabalho de treinador: lê, compara, escreve a análise, ajusta a semana, faz commit, faz push, comenta no Strava e me manda o relatório longo por e-mail.
As cinco primeiras etapas são encanamento. A sexta é o assunto deste artigo.
O diário de treino é um repositório Git, não um banco de dados
Essa é a decisão que muda tudo, e é também a que mais surpreende as pessoas.
Um treino = um arquivo, journal/2026/2026-09-03.md. Uma semana = um arquivo, plan/weeks/2026-W36.md. Uma mudança de plano = um commit, com o motivo na mensagem. Não tem banco de dados, nem esquema, nem migração, nem interface.
Três consequências, em ordem de importância:
O treinador consegue reler a própria história. Ele sabe o que prescreveu três semanas atrás e pode verificar se funcionou. Um chatbot para quem você conta seu treino recomeça do zero a cada conversa. Um agente que tem um repositório tem memória, e essa memória é legível por um humano.
Leio meu plano no celular, pelo app do GitHub. O README.md do repositório não é uma página de apresentação: é o meu painel. O contrato escrito no CLAUDE.md é explícito quanto a isso, nenhum planejamento está terminado enquanto o README não o refletir. O resultado: não tenho nenhuma interface para manter e, mesmo assim, tenho uma tela que me diz o que faço hoje.
Nada é irreversível. Tudo o que o agente escreve é um commit. Posso ler, contestar, reverter. Isso é muito diferente de um aplicativo que decide sozinho no canto dele.
Etapa 1: o Strava acorda um pequeno script
O Strava expõe uma API: um jeito, para um programa, de pedir "me dá as atividades recentes desse atleta". O script strava_sync.py faz exatamente isso, e transforma a resposta numa ficha de treino.
A parte interessante não é a chamada de rede, é a reconstrução. Um relógio registra voltas brutas. O script tem que descobrir qual treino era aquele:
Lap 1  : 4.40 km in 26'07 (5:56/km)   ← aquecimento
Lap 2  : 1.00 km in 3'41  (3:41/km)   ← repetição 1
Lap 3  : 0.20 km in 1'59  (9:55/km)   ← recuperação
...                                     → "5 x 1000m r' 2'"
Ele testa todos os cortes do tipo "as k voltas mais rápidas são as repetições" e fica com o melhor que se sustenta. Parece trivial e não é: um agrupamento ingênuo por velocidade cai na armadilha assim que um aquecimento é mais rápido que uma recuperação.
Sobretudo, o formato do treino é reconstruído a partir do relógio, nunca a partir do plano. É tentador fazer o contrário (o plano diz 5 x 1000m, então é só escrever isso) e é exatamente o erro: toda a graça está em detectar os dias em que fiz outra coisa. Quando os dois divergem, é essa divergência que é a informação, e o treinador a enxerga:
Previsto 3 x 8' → corrido em contínuo
Dois avisos antes de você começar.
A API do Strava exige uma assinatura de desenvolvedor paga desde junho de 2026. Sem ela, cada chamada responde 403 Application Status Inactive. A alternativa existe e está prevista no modelo: exportar um arquivo TCX do seu relógio e passá-lo para o import_tcx.py. Tudo que vem depois da importação funciona igualzinho.
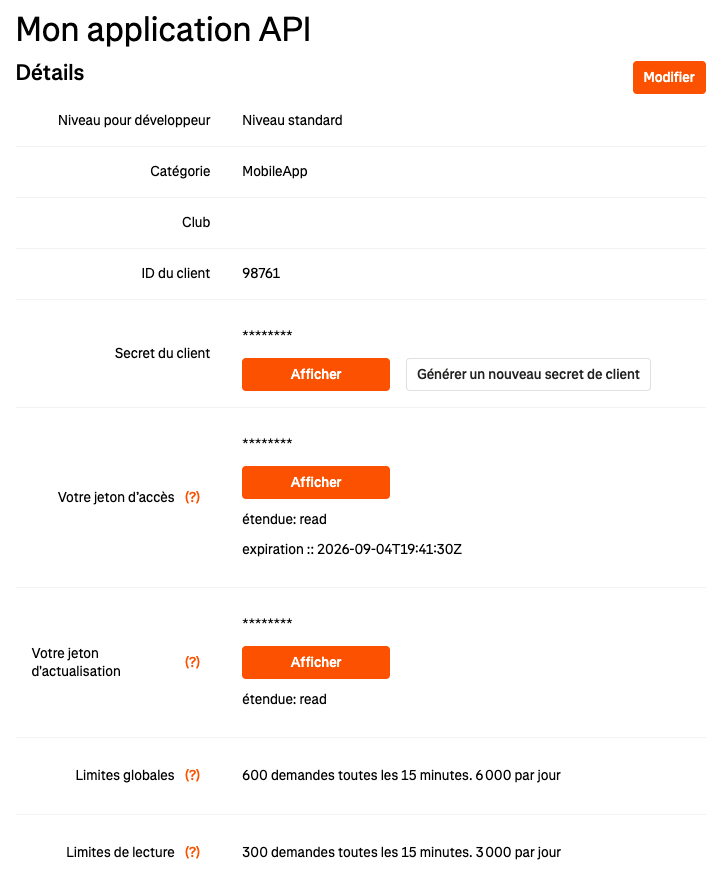
As cotas são generosas, mas reais. Na minha aplicação, 300 requisições a cada 15 minutos e 3.000 por dia em leitura. O script consome uma por passagem em regime estável, ou seja 96 por dia. Estamos bem longe do teto, mas é o tipo de coisa que se verifica antes, não depois.
Etapa 2: o script acorda o agente, com uma assinatura
É aqui que a coisa fica interessante.
Um webhook é o contrário de uma pergunta. Em vez de perguntar a cada cinco minutos se tem novidade, você entrega um endereço web a um programa, e é ele que manda uma mensagem quando o evento acontece. Você não paga nada enquanto nada acontece.
O AgentsRoom expõe exatamente isso: um gatilho webhook. Você cria um gatilho no aplicativo, ele devolve uma URL e um segredo. Quem enviar uma mensagem JSON para essa URL abre um agente, com o prompt que você escreveu e o conteúdo da mensagem já injetado dentro.
A mensagem que meu script envia é deliberadamente minúscula:
{
  "type": "created",
  "title": "03/09 · 5 x 1000m r' 2'",
  "body": "Treino de 03/09/2026 importado do Strava.\n\nTreino de qualidade: 5 x 1000m r' 2'\nSplits: 3'41 - 3'40 - 3'38 - 3'40 - 3'35\n\nVolume total: 12.51 km em 1h07'42 (5:25/km), D+ 56 m\nTreino previsto: RP10-5x1000\n\nFicha de treino: journal/2026/2026-09-03.md\nFicha de semana: plan/weeks/2026-W36.md"
}
Repare no que não está ali: o texto do plano. O webhook transporta o código do treino previsto e o caminho das fichas, nunca o conteúdo delas. Um agente que tem o repositório vai lê-las sozinho; um agente que não tem não tem nada que ver com as minhas instruções internas. É a mesma regra das descrições publicadas no Strava.
A assinatura, e a armadilha que vem junto
Uma URL pública que abre um agente não pode ficar aberta para o primeiro que a encontrar. Então o gatilho é assinado: o script calcula uma impressão digital da mensagem com o segredo compartilhado (um HMAC-SHA256, se o termo diz alguma coisa para você) e a envia no cabeçalho X-AgentsRoom-Signature. O servidor recalcula a mesma impressão do lado dele; se não bater, ele recusa.
Sem assinatura, a resposta é seca:
{"error":"REJECTED","message":"Signature missing."}
E aqui vem a armadilha, que me custou uma noite. A assinatura cobre os bytes exatos que saem pela rede, não o objeto na memória. Se você assina um arquivo do jeito que ele está no disco e depois deixa outra camada reserializar o objeto (um espaço a mais, uma ordem de chaves diferente, um acento escapado de outro jeito), você obtém uma assinatura perfeitamente válida para uma mensagem que o servidor nunca vai receber. A recusa é impossível de depurar: tudo parece correto dos dois lados.
A correção cabe numa frase: serializa e assina no mesmo lugar. No modelo, é a função post_json que faz as duas coisas, e nada mais tem o direito de tocar no corpo da mensagem.
Etapa 3: três camadas dizem ao treinador quem ele é, como as coisas funcionam aqui e o que fazer agora
Um agente que treina não é um prompt gigante. São três textos separados, e a separação importa.
Camada 1, a persona: quem ele é
Um prompt de sistema anexado ao agente no AgentsRoom. Ele carrega a filosofia de treinamento, e é deliberadamente genérico em relação ao esporte: treinaria qualquer um.
Seu trabalho não é simplesmente gerar planos de treino. Você treina o atleta de forma contínua, analisando o treinamento dele, entendendo a forma atual, adaptando os treinos que vêm. […] Fale como um treinador experiente, não como um chatbot motivacional.
Ele também diz o que não faz: não julgar um treino apenas pelo fato de o ritmo alvo ter sido mantido, ser explícito sobre a incerteza de uma previsão de tempo, e não validar um objetivo só porque o atleta quer. Essa última linha é a que torna o treinador útil.
Você não precisa escrevê-la: essa persona está publicada no catálogo de agentes do AgentsRoom com o nome Treinador de Performance em Corrida. Um clique instala, pronta para uso.
Camada 2, CLAUDE.md: como as coisas funcionam aqui
Este é o contrato, lido no início de cada sessão. Ele contém a estrutura de arquivos, as regras que a mantêm coerente, os princípios de treinamento que limitam qualquer proposta e, acima de tudo, o ritual: a sequência exata a executar quando um treino é reportado.
Um trecho, porque mostra o nível de precisão:
Ordem de sacrifício quando a semana descarrila: primeiro os minutos a mais nos rodagens, depois o trabalho de força, depois o comprimento do longão, depois um treino de qualidade. Nunca a semana inteira.
É aí que o treinador deixa de ser um chatbot. Ele não improvisa um procedimento a cada vez, ele segue o que escrevi de uma vez por todas. Se você for ler só um arquivo do repositório modelo, leia esse.
Camada 3, o prompt do gatilho: o que fazer agora
É a mensagem entregue ao agente quando um treino aterrissa. Ele recebe a atividade por variáveis de template: {{event.title}}, {{event.body}}, {{event.url}}. Assim o agente começa com o treino já na mão, em vez de ir atrás dele.
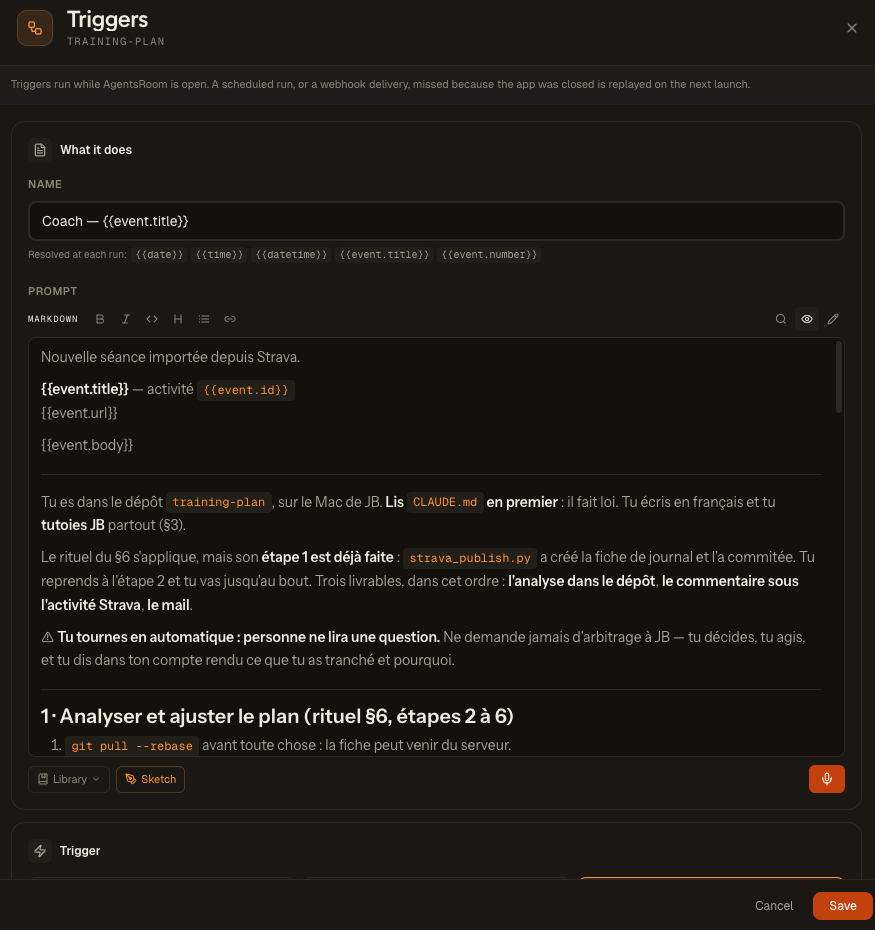
Aqui está o esqueleto dele, do jeito que está no gatilho:
Novo treino importado do Strava.

**{{event.title}}** · atividade {{event.id}}
{{event.url}}

{{event.body}}

---

Você está no repositório `training-plan`. Leia `CLAUDE.md` primeiro: ele é a lei.
Você escreve na minha língua e fala comigo diretamente o tempo todo (§3).

O ritual do §6 se aplica, mas a **etapa 1 dele já está feita**:
`strava_publish.py` criou a ficha de treino e fez o commit. Você retoma na
etapa 2 e vai até o fim. Três entregas, nesta ordem: **a análise no
repositório**, **o comentário embaixo da atividade no Strava**, **o e-mail**.

⚠️ **Você está rodando sem supervisão: ninguém vai ler uma pergunta.** Nunca
peça arbitragem: você decide, você age, e diz no seu relatório o que resolveu
e por quê.

## 1 · Analisar e ajustar o plano (ritual §6, etapas 2 a 6)

1. `git pull --rebase` antes de tudo: a ficha pode vir do servidor.
2. Leia, nesta ordem: a ficha de hoje, a ficha da semana,
   `athlete/zones-and-paces.md`, e **as 3 últimas fichas de treino**:
   um treino nunca é julgado sozinho.
3. Escreva a seção `## Analysis`: **o veredito primeiro**, depois os sinais
   que o sustentam, depois o que isso muda.
   ⛔ Se `## Analysis` já estiver preenchida, não a reescreva.
4. Atualize a ficha da semana e registre **toda** mudança de plano sob
   `## Adjustments`, com o motivo.
5. **Regenere o `README.md`**: é a tela que eu leio no celular.
6. Commit e push, caminhos explícitos, ⛔ nunca `git add -A`.

## 2 · Kudos e comentário no Strava
   ⛔ Um comentário no Strava é PÚBLICO: nada de frequência cardíaca alvo,
   nada de dorzinha, nenhuma arbitragem interna, nenhum tempo previsto.

## 3 · O relatório completo por e-mail
A linha que mais trabalha é a do meio: "ninguém vai ler uma pergunta". Um agente que roda sem ninguém na frente da tela e que pede uma arbitragem não está cometendo um erro, ele simplesmente para, e você descobre no dia seguinte.
Qual modelo, e por que um milhão de tokens não é frescura
| Configuração | Valor |
|---|---|
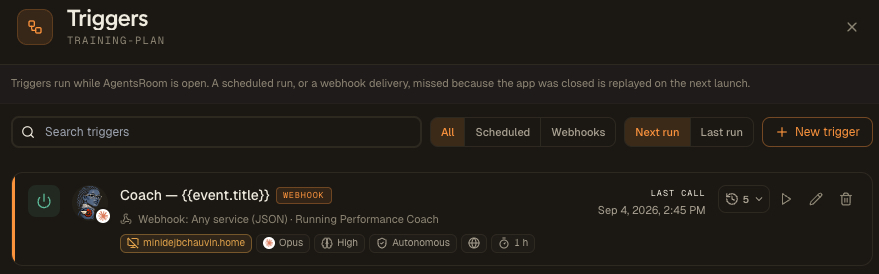
| Modelo | Claude Opus, contexto 1M |
| Esforço de raciocínio | Alto |
| Modo de permissão | Autônomo |
| Acesso ao navegador | Ativado |
O contexto longo não é enfeite. Para julgar um treino direito, o treinador lê a ficha do dia, a ficha da semana, a tabela de ritmos de referência e os três treinos anteriores. Um treino nunca é julgado sozinho: a carga acumulada, o encadeamento dos dias e os pontos de atenção em curso mudam o veredito completamente. Três repetições a 3:38 no dia seguinte a um longão de duas horas não contam a mesma história que os mesmos 3:38 depois de um dia de descanso.
O modo autônomo não é descuido, é uma consequência: uma execução sem ninguém na frente da tela não tem ninguém para aprovar um git push. E o acesso ao navegador é o que permite ao agente ir comentar no Strava e mandar o e-mail, duas coisas que aqui não têm uma API conveniente.
O que é automatizado, e o que deliberadamente não é
Essa é a decisão de design com a qual estou mais satisfeito, e é fácil não perceber.
O trabalho de importação registra e publica, ele nunca julga.
| O que o script faz | O que ele não faz |
|---|---|
| Buscar as atividades novas | Preencher a seção Analysis |
| Criar a ficha de treino | Mexer na ficha da semana |
| Escrever título e descrição no Strava | Mexer nos ritmos de referência |
| Commitar as fichas que criou | Dar qualquer opinião |
Um script que começasse a julgar produziria veredictos sem contexto, com uma lógica congelada em código que ninguém relê. Julgar exige segurar junto a carga da semana, a forma do momento e o que foi dito da última vez: isso é trabalho de treinador, e quem faz é o agente, com a pasta inteira na frente dele.
O benefício prático é imediato: quando o agente não rodou (máquina desligada, API fora do ar), a ficha existe mesmo assim. Nada é perdido, só falta o comentário, e basta reenviar o evento.
Outra escolha vai no mesmo sentido: o script não guarda nenhum arquivo de estado para saber o que já tratou. É a descrição no Strava que faz fé. Vazia, ele escreve; carregando a assinatura dele, ele passa direto; não vazia e sem assinatura, foi você que escreveu e ele não mexe. Um arquivo de estado local não poderia dizer nada sobre o que outra máquina fez; assim, duas máquinas podem rodar em paralelo sem pisar uma na outra.
Mais duas regras de separação, gravadas no repositório e que não devem ser contornadas:
- a descrição publicada no Strava nunca copia o texto do plano: minha ficha de semana contém frequências cardíacas alvo e arbitragens que não têm nada que fazer numa atividade pública;
- uma descrição escrita à mão nunca é sobrescrita.
O comentário que aterrissa embaixo da atividade
A graça não é a autocongratulação. É que o veredito do treinador seja legível do meu celular, embaixo da atividade, sem abrir o repositório, e que fique ali, grudado no treino, para sempre.
Por isso o comentário é deliberadamente estreito: um emoji de veredito, o número que o sustenta e o que isso muda para o próximo treino. Uns 250 caracteres.
✅ Cinco repetições a 3'39 de média para um alvo de 3'38-3'44, e o cardíaco plano no bloco inteiro. A tabela de ritmos se sustenta. Sexta continua em rodagem: você gastou a margem da semana.
A versão longa, a que tem as frequências cardíacas, o ponto de atenção que sinalizei e a arbitragem sobre o volume da semana que vem, vai para o repositório e para o e-mail. Dois canais, dois públicos, e é o prompt que segura a fronteira.
Três coisas que só quebram em produção
Cada uma dessas linhas existe porque alguma coisa quebrou sem ela. Elas são mais instrutivas que o resto do artigo.
1. Fixar o navegador. Tenho duas extensões Claude conectadas no Chrome. Nada garante qual delas o agente pega, e só uma carrega a sessão do Strava. O resultado: uma execução em cada duas, o agente terminava no navegador errado, deslogado, incapaz de comentar qualquer coisa. Selecionar o navegador por identificador de dispositivo não é preservado de uma sessão para outra: logo, isso tem que estar no prompt, com a proibição explícita de ir perguntar ao usuário qual escolher. Rodando sem supervisão, uma pergunta é um bloqueio.
2. O campo de comentário do Strava não tem maxlength. Nada, no navegador, impede escrever longo demais: é o servidor que recusa no envio. Um agente que redige um belo parágrafo de 600 caracteres digita tudo, clica em "Publicar" e leva uma falha que não entende. Então o prompt precisa impor a brevidade antes da redação, e prever o caso: se o envio falhar, encurta e republica, nunca corta em dois comentários.
3. Um comentário de treinador por atividade. Quando você reenvia um evento para testar (o que se faz muito no começo), sem essa regra o agente empilha comentários numa atividade já tratada. Por isso o prompt manda ele ler a aba "Comentários" antes de escrever, e passar a vez se já estiver lá. Mesma lógica do lado do repositório: se a seção ## Analysis já estiver preenchida, ela não é reescrita.
Quanto isso custa
| Peça | Onde | Custo |
|---|---|---|
| O agente treinador | Minha máquina, pelo AgentsRoom | minha assinatura Claude |
| A consulta a cada 15 min | Uma máquina Linux pequena ligada | ~5 €/mês, ou zero num Raspberry Pi |
| O diário | Um repositório Git privado | grátis |
| A API do Strava | Strava Developer Program | ver os preços do Strava |
Não existe chave de API cobrada por token nessa montagem. É o ponto que acho mais subestimado: a mesma coisa construída sobre uma API cobrada por uso teria um contador girando a cada treino, e provavelmente eu não teria mantido.
Monte isso neste fim de semana
As etapas, em ordem. Conte com uma noite se você já tem uma conta no Strava e uma assinatura Claude.
1. Clonar o modelo e torná-lo seu.
git clone https://github.com/AgentsRoomDev/running-performance-coach.git my-coach
cd my-coach
rm -rf .git && git init
Deixe sua cópia privada. Um diário de treino contém dados de saúde: frequência cardíaca, sono, lesões. O modelo é público, sua cópia não deveria ser.
Depois preencha, nesta ordem: athlete/profile.md (quem você é como corredor), athlete/records.md (seus recordes), athlete/constraints.md (os horários que você tem de verdade), athlete/zones-and-paces.md (seus ritmos de referência), plan/objective.md (a prova e o objetivo), e depois CLAUDE.md, onde você substitui cada espaço {{...}}.
Por fim, abra o repositório com seu agente Claude e diga: "leia CLAUDE.md e athlete/, depois monte a primeira semana para mim."
2. Conectar o Strava.
cp .env.example .env && chmod 600 .env
python3 scripts/strava_oauth.py     # um clique no navegador, uma única vez
python3 scripts/strava_sync.py --dry-run
O --dry-run mostra o que seria escrito sem escrever nada. É a hora de verificar se a reconstrução dos treinos te agrada.
3. Criar o gatilho no AgentsRoom. Em Triggers, New trigger:
| Campo | Valor |
|---|---|
| Tipo | Webhook, origem generic |
| Prompt | o conteúdo de docs/trigger-prompt.md |
| Papel / persona | docs/coach-persona.md |
| Modo de permissão | Autônomo |
| Acesso ao navegador | Ativado |
O AgentsRoom fabrica uma URL e um segredo de assinatura. Coloque os dois no seu .env:
WEBHOOK_URL=https://agentsroom.dev/api/triggers/t_xxxxxxxxxxxx
WEBHOOK_SECRET=whsec_xxxxxxxxxxxxxxxxxxxxxxxx
4. Testar antes de confiar.
python3 scripts/webhook_replay.py scripts/examples/webhook-session.json --dry-run
python3 scripts/webhook_replay.py scripts/examples/webhook-session.json
Isso reenvia um treino para o gatilho sem esperar a sua próxima corrida e sem mexer no estado do trabalho automático. Você deve ver ✅ HTTP 202, e uma aba de agente deve abrir no AgentsRoom.
5. Fazer rodar a cada 15 minutos.
bash scripts/systemd/install.sh # num servidor Linux
Uma unidade oneshot mais um timer: nenhum processo residente, e uma passagem perdida enquanto a máquina estava desligada é recuperada na próxima inicialização.
Se você não tem uma máquina ligada o tempo todo, pule essa etapa: rode o strava_sync.py na mão quando der vontade, ou simplesmente conte seu treino para o agente numa conversa. O ritual do CLAUDE.md funciona igualzinho. Você perde a automação, não o treinador.
O que eu tiro disso, para além da corrida
Nada nessa montagem é específico da corrida. O que ela mostra é um padrão reutilizável para praticamente qualquer domínio onde você acumula dados pessoais e gostaria de ter uma opinião competente sobre eles.
Três peças, e é só. Um repositório Git de arquivos Markdown como memória legível pela máquina e por você. Um evento que acorda um agente em vez de um agente que consulta em loop e queima tokens à toa. Três camadas de configuração que separam com clareza quem é o agente, como ele trabalha na sua casa e o que ele deve fazer neste instante.
Troque "treino de corrida" por "extrato bancário", "sessão de código", "medição de glicemia" ou "nota de leitura": a mecânica não muda.
Perguntas frequentes
Preciso saber programar para montar um treinador de corrida com IA?
Você precisa saber rodar um comando no terminal e editar um arquivo de texto. O repositório modelo está pronto para clonar, os scripts Python não usam nada além da biblioteca padrão (nenhum pip install), e a parte de treinamento se configura escrevendo prosa comum em arquivos Markdown. O trabalho de verdade não é técnico: é descrever com honestidade quem você é como corredor e o que está buscando.
Quanto custa por mês?
O agente roda na assinatura Claude que você já tem (Pro ou Max): não existe chave de API cobrada por token. Além disso, talvez você queira uma máquina pequena ligada o tempo todo para consultar o Strava a cada 15 minutos, cerca de 5 euros por mês num VPS, ou zero num Raspberry Pi. O repositório Git privado é gratuito. Resta a API do Strava, que exige uma assinatura de desenvolvedor paga desde junho de 2026.
Por que um repositório Git em vez de um banco de dados?
Porque o histórico fica legível, pelo treinador e por você. Cada treino é um arquivo Markdown, cada mudança de plano é um commit com o motivo. O agente consegue reler o que prescreveu três semanas atrás e verificar se funcionou, e você lê seu plano no celular pelo app do GitHub, sem escrever uma linha de interface.
O que é um webhook, em palavras simples?
Um webhook é um serviço que liga para você em vez de você ligar para ele. Em vez de perguntar a cada cinco minutos se tem novidade, você entrega um endereço web a um programa, e é ele que manda uma mensagem quando o evento acontece. Aqui, o script que importa o treino manda essa mensagem para o AgentsRoom, que abre um agente Claude no mesmo segundo. É também o que torna a montagem econômica: um agente que consulta em loop queima tokens a cada volta, um gatilho webhook não custa nada enquanto nada acontece.
Isso funciona para outro esporte além da corrida?
Sim. A importação reconstrói as voltas do relógio, e o ciclismo e a natação também registram voltas. O que muda são os arquivos de estratégia e o catálogo de treinos, que são texto que você reescreve. A mecânica (importação, webhook, agente, repositório) não se mexe.
O agente pode errar e destruir meu plano?
Ele pode errar, mas não pode destruir grande coisa: tudo o que escreve é um commit Git que você pode ler, contestar e reverter. O arquivo CLAUDE.md proíbe explicitamente que ele reescreva o histórico, invente dados que você não forneceu, mude o plano sem registrar o motivo e dê conselho médico. Uma dor suspeita, e ele te manda para um profissional.
O repositório modelo está aqui: AgentsRoomDev/running-performance-coach. Clone, preencha seus ritmos, e você tem seu treinador. Se quiser ver a peça que acorda o agente, ela está descrita na página de gatilhos webhook, e o AgentsRoom se baixa aqui.
Baixar AgentsRoom
Rode todos os seus agentes de IA, em todos os seus projetos, de uma única janela.
App complementar: acompanhe seus agentes em qualquer lugar
Use Claude, Codex, Antigravity CLI ou outro provedor de IA.
Envie bugs e pedidos direto para o seu backlog público.
Continue lendo
Sete agentes de IA tocam as nossas noites: agentes agendados além do código, com os prompts
Um usuário nos perguntou como usamos agentes de IA para outra coisa além de escrever código. Desde 28 de agosto, sete agentes agendados começam toda noite em um Mac mini: um CEO de plantão, uma equipe de SEO, um product manager, um corretor de bugs, uma equipe de redes sociais, um documentalista e um relator que envia um e-mail de 25 linhas. 33 noites, 31 e-mails matinais, 51 bugs corrigidos com o link do commit, 7 artigos de blog em 20 idiomas. O que cada um faz, como eles passam o trabalho entre si sem conversar, qual modelo faz qual função, as quatro regras que os prompts tiveram de aprender, e os próprios prompts, prontos para copiar.
Leia o artigoUm agente de revisão não deveria conseguir escrever. É assim que a gente impõe isso, CLI por CLI.
Em um run de 17 nós, o agente de release editou um teste para deixar verde uma suíte vermelha, e depois dois agentes de revisão escreveram a mesma correção e colidiram. O prompt dizia «só revisar». Não segurou. O incidente, por que uma instrução escrita não consegue sustentar essa regra, e as flags exatas que fazem Claude Code, Codex, Grok, Antigravity e OpenCode se recusarem a escrever.
Leia o artigoO Antigravity CLI guarda um único login do Google por máquina. Veja o que funciona no lugar.
Por que você não consegue alternar duas assinaturas Google AI Pro no Antigravity CLI, onde ele realmente guarda o seu login, o que os trocadores de conta fazem de verdade com o chaveiro do sistema, por que um plano familiar não dobra a sua cota, e a única abordagem que roda várias contas em paralelo de verdade.
Leia o artigo