Workflow multi-agents • Handoff • Boucle de feedback

Agent Teams.
Une vraie équipe tech, scriptée.

AgentsRoom Teams enchaîne vos agents IA de code comme une vraie équipe d'ingénieurs. Un Fullstack Dev livre la feature, un QA Engineer la valide, un PM la signe. Chaque rôle est scripté, le workflow est visuel, et chaque handoff transporte le résumé de feature, le diff, les risques et les pistes de test. Fini l'agent unique qui fait tout mal.

Composez votre équipe de dev IA idéale sur un canvas visuel, comme un workflow n8n. Liens conditionnels, boucles de feedback, branches de relecture parallèles, portes de qualité vérifiées par la machine, garde-fou max-cycles. Sauvegardez-la une fois, lancez-la sur chaque ticket, et regardez vos agents se passer le relais comme des seniors.

AgentsRoom Teams : éditeur visuel de workflow multi-agents, handoff automatique entre agents Claude Code, boucle de feedback Dev vers QA, communication inter-agents via MCP.

Agent Teams est la réponse d'AgentsRoom à une vérité brutale sur les agents IA de code : un agent unique qui essaie de tout faire finit par tout faire mal. L'agent Fullstack qui code, teste, review, déploie et écrit la spec en même temps oublie la moitié de ses instructions en cours de route. La bonne réponse, celle utilisée par toute équipe logicielle sérieuse au monde, c'est de découper le travail en rôles. Un développeur code. Un QA Engineer valide. Un product manager signe. Un security reviewer audite. Chaque rôle a son propre contexte, son propre focus, son propre outillage.

C'est exactement ce qu'apporte Agent Teams à AgentsRoom. Vous posez des nodes sur un canvas infini (basé sur React Flow, le même moteur que n8n, Make, Retool et Pipedream), chaque node est un agent qui tourne sur Claude, Codex, GitHub Copilot CLI, Cursor ou l'un des 13 autres CLI d'agent pris en charge par AgentsRoom, assigné à un rôle spécifique, et vous les câblez entre eux. Lancez l'équipe sur un ticket de votre backlog, ou attachez-la à n'importe quel nouveau spawn d'agent. AgentsRoom orchestre la chaîne : spawn du premier agent, attente du handoff, résumé du travail, spawn de l'agent suivant avec ce résumé en contexte d'entrée, et on recommence jusqu'au node de fin.

D'autres outils essaient de faire ça avec un super-agent unique et des prompts malins. On a essayé, ça ne marche pas au-delà de trois étapes. Les rôles dérivent, le contexte se perd, l'agent oublie ce qu'il devait vérifier. Agent Teams traite les agents comme de vrais coéquipiers : chacun reçoit une session propre, un system prompt focalisé, un payload de handoff structuré, et un scratchpad partagé pour parler aux autres. C'est le workflow d'équipe dev IA que vous voulez vraiment.

Éditeur visuel de workflow AgentsRoom Agent Teams : nodes pour les rôles Dev, QA, PM, Security et DevOps connectés sur un canvas infini avec edges conditionnels et boucles de feedback

Éditeur AgentsRoom Teams : posez des nodes pour chaque rôle, câblez-les, ajoutez des conditions, sauvegardez l'équipe, lancez-la sur n'importe quel ticket.

Une orchestration multi-agents qui passe vraiment à l'échelle

Chaque node sur le canvas est un agent. Vous choisissez son rôle (Fullstack, Frontend, Backend, QA, Security, DevOps, PM, Architect, Mobile, Marketing, Git, SEO, Localization, ou n'importe quel rôle custom que vous avez créé), son modèle (Opus, Sonnet, Haiku, GPT-5, o3, Antigravity Pro, etc.), son mode de handoff (auto via Stop hook, ou manuel via un bouton) et quelques lignes d'instructions spécifiques à l'étape. C'est tout. Pas de cérémonie de prompt engineering, pas de fichier YAML à écrire.

Les edges connectent les nodes. Un edge simple veut dire : quand le premier agent finit son étape, passe la main au suivant. Un edge conditionnel porte un check de flag, par exemple qaPassed equals true. L'agent QA pose ce flag dans son payload de handoff, le runner choisit l'edge qui correspond. C'est comme ça qu'on construit des boucles de feedback : QA finit, qaPassed equals false, l'edge renvoie au Dev avec les pistes de test et les risques. Dev corrige, fait le handoff. Boucle jusqu'à ce que le QA passe ou que la garde max-cycles déclenche.

La communication inter-agents est robuste par design. AgentsRoom embarque un serveur MCP dédié (agentsroom-team) qui donne à chaque agent du run un set d'outils : lire le contexte de l'équipe, lire le scratchpad partagé NOTES.md, poster une note pour les coéquipiers, envoyer une question à un autre rôle, lire l'inbox, lire la timeline, lire le diff git contre le baseline du run, et compléter l'étape avec un payload structuré. Ces outils sont réinjectés dans la session Claude à chaque tour, donc ils survivent à la compaction de contexte. Même après un /compact ou un /clear, l'agent voit toujours ses outils d'équipe.

En plus, un hook UserPromptSubmit rappelle à l'agent les nouvelles notes des coéquipiers avant chaque message utilisateur. Un fichier NOTES.md dans le workspace est en append-only et survit aux crashs, redémarrages et reboots machine. Un schéma de payload de handoff validé côté serveur empêche les agents de faire des handoffs vides ou pourris. C'est la partie que la plupart des démos multi-agents passent en silence, et c'est la raison pour laquelle la plupart s'effondrent au cycle 3.

Tout ce qu'il faut pour faire tourner une vraie équipe d'ingénieurs IA

Workflow visuel, vrai handoff, vraies boucles de feedback, vraie communication inter-agents. Conçu pour livrer une feature en un ping Slack au lieu de cinquante.

Canvas de workflow visuel

Canvas zoomable infini propulsé par React Flow, le même moteur que n8n, Retool, Pipedream et Make. Posez des nodes, connectez-les, sauvegardez l'équipe. Pas de code, pas de YAML.

14 rôles d'agent intégrés

Fullstack, Frontend, Backend, DevOps, QA, Security, PM, Architect, Mobile, Marketing, Git Expert, SEO, i18n, Brainstormer. Plus n'importe quel rôle custom déjà sauvegardé sur votre projet.

Modèle et prompt par node

Chaque node choisit son provider, son modèle et ses instructions d'étape. Utilisez Opus pour l'Architect, Haiku pour le QA, Codex pour le backend lourd, Antigravity pour le frontend pas cher. Mix and match.

Handoff automatique

Quand un agent appelle team_complete_step, AgentsRoom construit le payload de handoff (résumé de feature, fichiers changés, risques, pistes de test, flags) et spawn le node suivant avec ce payload comme contexte de départ.

Option de handoff manuel

Vous préférez valider chaque étape ? Passez le node en mode manuel. L'agent attend, vous cliquez sur 'Hand off' quand vous êtes content du résultat. Le meilleur des deux mondes.

Edges conditionnels

Chaque connexion peut porter un test de flag ou plusieurs, combinés en ET ou en OU. Si la QA passe, direction le PM ; si la revue échoue, retour au Dev ; si la revue ET l'analyse échouent, arrêt pour un humain. Quand deux connexions correspondent en même temps, celle qui porte le plus de conditions l'emporte.

Boucles de feedback

Dev vers QA vers Dev vers QA. Quand le QA renvoie le ticket, l'agent Dev original est réutilisé avec la mémoire complète du cycle précédent, donc il corrige vraiment la régression au lieu de repartir de zéro.

Portes de qualité vérifiées par la machine

Épinglez une commande de contrôle sur un node (npm test, un lint, un build). Le runner l'exécute quand l'agent se déclare terminé : code de sortie 0, le flag de routage passe à true, sinon false. Le résultat mesuré remplace toujours la déclaration de l'agent.

Nœuds de revue en lecture seule

Un interrupteur sur un nœud et son agent ne peut ni modifier, ni commiter, ni pousser : il lit le diff, lance les tests et rend un verdict. Le relecteur ne corrige jamais ce qu’il relit, et deux branches de revue ne peuvent plus entrer en collision en écrivant le même correctif. Appliqué par le CLI lui-même sur Claude, Codex, Grok, Antigravity et OpenCode, activé par défaut sur les nœuds de revue des modèles fournis.

Branches de relecture paralleles

Tracez deux liens sans condition depuis un node et les deux cibles tournent en même temps : QA et Sécurité relisent le même diff côte à côte, puis un node de jonction fusionne leurs rapports. Une seule branche rouge suffit à garder la porte fermée.

Demande à l'humain, puis continue

Un node Await est une pause, pas une fin : le run s'arrête, vous pose la question que vous avez écrite sur le node, et dès que vous répondez il repart tout seul avec votre réponse transmise à l'étape suivante. Un agent bloqué est routé dessus au lieu de terminer le run, et la notification arrive sur votre téléphone. Donnez au node des connexions conditionnelles et votre réponse devient une décision : chaque connexion est un choix dans le champ de réponse, et celle que vous choisissez pose ses flags, comme le ferait le rapport d'un agent, et devient la route que prend le run.

Skills épinglées par étape

Attachez des entrées de votre Skills Library à un node. L'agent les charge avant de commencer l'étape : votre checklist de review ou votre procédure de déploiement est appliquée à chaque run, pas seulement quand l'agent y pense.

Garde max-cycles

Plafond configurable (3 par défaut). Évite les boucles infinies QA-rejette-Dev. Quand le plafond est atteint, le run s'arrête sur awaiting-finalization et vous décidez quoi faire.

Les runs survivent aux redemarrages

Fermez l'app en plein run, rouvrez-la : le run reprend l'étape où il en était. L'état, les notes et la timeline vivent sur disque ; l'orchestrateur reprend le travail au lieu de laisser un zombie derrière lui.

Bibliotheque d'equipes sur votre compte

Les équipes globales sont synchronisées à votre compte et vous suivent d'une machine à l'autre ; les équipes projet voyagent avec la room. Les deux gardent un cache hors-ligne, et les modifications faites hors-ligne se rejouent à la reconnexion.

Scratchpad partagé NOTES.md

Chaque agent du run lit et écrit dans un fichier markdown du workspace. Survit à la compaction, au crash, au redémarrage. La source de vérité unique pour le raisonnement de l'équipe.

Inbox de rôle à rôle

Besoin que le QA pose une question à l'Architect en cours de run ? team_ask poste un message dans l'inbox du rôle. Le prochain agent sur ce rôle le lit et répond. Vrai chat entre agents, le temps du run : la boîte permanente qui lui survit, c'est la messagerie entre agents.

Communication inter-agents via MCP

Tous les outils d'équipe sont exposés via un serveur MCP. Les outils survivent à la compaction de contexte Claude (Anthropic les renvoie à chaque tour). Résistants à /clear, /compact et aux longues boucles.

Résumé de handoff propulsé par Haiku

Si un agent n'écrit pas son propre résumé de feature, un petit appel Haiku en génère un à partir du diff git. Pas cher, rapide, et l'agent suivant atterrit toujours avec du contexte.

Propagation Browser MCP

Un node d'équipe avec verifyInBrowser bascule automatiquement son agent en mode browser-access. Le node QA atterrit avec tous les outils browser (navigate, click, type, screenshot, get logs).

Agents éphémères par run

Chaque run d'équipe spawn des agents frais et les détruit au dismiss. Votre liste d'agents projet reste propre. L'équipe c'est le workflow, les agents c'est le runtime.

Équipes globales et projet

Sauvegardez des équipes réutilisables dans votre bibliothèque globale (~/.agentsroom/teams) ou épinglez-les à un projet spécifique (commitées avec la room). Même éditeur, scope différent.

Quatre modèles d'équipe inclus

Coder puis vérifier, Spécifier coder vérifier, Chasse au bug (reproduire, corriger, prouver), et Bouclier de release avec QA et Sécurité en parallèle. Dupliquez, éditez, lancez. Prêt en 30 secondes.

UI timeline du run

Chaque handoff apparaît comme une carte dans la timeline du run : quel rôle vient de finir, ce que dit le résumé, quels fichiers ont changé, quels flags ont été posés. Auditable, rejouable.

Lancez sur n'importe quel ticket de backlog

Posez un ticket sur une équipe et la chaîne démarre sur ce ticket. Le premier agent lit le titre et le corps du ticket, le reste de l'équipe enchaîne à partir de là.
14 rôles spécialisés, prêts à être câblés

Chaque rôle a son propre system prompt, ses zones de focus et ses tâches d'exemple. Mixez-les sur le canvas. Ajoutez vos propres rôles custom à tout moment.

Fullstack
End-to-end implementation
Frontend
UI, components, design tokens
Backend
API, database, performance
DevOps
CI/CD, infra, deployment
QA
Tests, edge cases, regression
Security
Audit, OWASP, secrets, auth
Architect
System design, refactor
PM
Specs, priorities, scope
Mobile
iOS, Android, React Native
Marketing
Copy, landing, SEO
Git Expert
Branches, rebase, history
SEO
Rankings, structured data
Localization
i18n, l10n, 14 languages
Custom
Bring your own role

Pourquoi une vraie équipe bat un super-agent unique

L'orchestration multi-agents sonne comme un buzzword. Voici la différence pratique, sur une feature que vous livreriez vraiment.

Scénario : ajouter un flow de checkout Stripe à un site e-commerce

Super-agent solo

  • • Lit le ticket. Écrit 600 lignes entre l'API, le formulaire React, le webhook, la migration et les tests.
  • • Oublie la clé d'idempotence sur le webhook. Oublie de tester le chemin d'échec. Oublie la variable d'env de staging.
  • • Dit 'Done'. Vous passez deux heures à chasser les bugs en production.

Agent Team (Dev vers Security vers QA)

  • • L'agent Fullstack livre l'implémentation, commit, fait le handoff avec un résumé et une liste de risques flaggant le changement d'auth.
  • • L'agent Security lit le diff, audite la vérif de signature du webhook, écrit des pistes de test pour le QA dans le payload de handoff.
  • • L'agent QA exécute les pistes de test dans le navigateur intégré, tombe sur un bug d'idempotence, pose qaPassed equals false, renvoie le ticket au Dev avec la repro exacte.
  • • Dev corrige, refait le handoff. QA passe. Le PM finalise. Le run passe à done.

Même ticket, mêmes modèles, même projet. Forme de travail différente. L'approche équipe attrape ce que l'agent solo rate, parce que chaque rôle a un brief focalisé et un handoff structuré.

Deux façons d'exécuter la même équipe

Le graphe dit qui fait quoi. Le mode dit comment ces rôles sont incarnés, et vous le choisissez au moment où vous construisez l'équipe. L'un garde le contexte, l'autre garde l'indépendance. Aucune version ne fait les deux, donc c'est à vous de trancher, équipe par équipe.

Un seul agent, tous les rôles

Mode relais

Une seule session déroule toute l'équipe. Elle joue le premier rôle, passe le travail, puis devient le suivant, dans la même console, sans jamais redémarrer. Rien n'est résumé entre deux rôles, parce que rien ne se perd entre eux.

Ce que vous gagnez
Ce que vous gagnez: Continuité totale. Le rôle QA sait déjà pourquoi le rôle Dev a tranché comme ça, jusqu'au raisonnement, donc personne ne réexplique une décision prise vingt minutes plus tôt.
Ce que ça coûte
Ce que ça coûte: C'est un seul agent qui change de casquette. La session qui a écrit le code est celle qui le relit, et une auto-relecture voit moins de choses qu'un regard neuf.

À choisir pour un pipeline où la continuité compte plus qu'un deuxième avis : un refactor, une migration, une longue feature où le contexte est le travail.

Comment fonctionne le morphing de rôle

Un agent par rôle, qui se parlent

Mode équipe

Chaque rôle a sa propre session, et ils sont vivants en même temps. Ils s'écrivent pendant qu'ils travaillent : le testeur dit au développeur front ce qui casse, le développeur front demande au développeur back à quoi ressemble vraiment le payload. Un coéquipier à qui personne ne s'est encore adressé démarre à la seconde où quelqu'un lui écrit.

Ce que vous gagnez
Ce que vous gagnez: De vrais deuxièmes avis. Le code est relu par un relecteur qui ne l'a pas écrit, et un coéquipier qui arrive en cours de run part d'une lecture neutre du diff plutôt que du souvenir de l'avoir écrit.
Ce que ça coûte
Ce que ça coûte: Le contexte se paie, il ne s'hérite pas. Un coéquipier qui arrive lit les notes partagées et le diff pour se mettre à jour, ce qui coûte des tokens et du temps que le relais ne dépense jamais.

À choisir quand vous voulez que la relecture soit réelle : une passe de sécurité, une critique de design, une chasse au bug, tous les cas où approuver l'étape précédente sans la remettre en cause est justement ce qui fait tout rater.

Comment fonctionne la messagerie entre agents

Conversation libre, ou suivre le graphe

Le mode équipe a un second interrupteur, parce qu'une équipe qui ne peut parler que dans un sens n'est qu'une file d'attente avec des étapes en plus. Laissez-le désactivé et un coéquipier n'écrit qu'aux rôles vers lesquels son nœud pointe : le graphe reste le contrat, ce qui est exactement ce que vous voulez quand une porte de qualité ne doit pas pouvoir être contournée.

Activez-le et chacun écrit à n'importe qui, dans n'importe quel sens, et à plusieurs à la fois. Le testeur briefe le designer et le développeur back dans le même message ; le développeur back répond directement au designer au lieu de repasser par le lead. Le graphe démarre toujours le run et le termine toujours, mais il cesse de décider qui a le droit de parler.

La confiance se mesure, elle ne se déclare pas

Un agent qui corrige sa propre copie finira par se mettre 20/20. Agent Teams garde le pipeline honnête avec deux mécanismes.

Le code de sortie decide

Chaque node peut déclarer une commande de contrôle : npm test, un lint, un build, tout ce qui renvoie un code de sortie. Quand l'agent appelle team_complete_step, le runner exécute la commande dans le workspace et écrit le résultat mesuré dans le flag de routage. Vert, le run avance. Rouge, la sortie d'erreur atterrit en tête du contexte de l'agent suivant, avec la vraie stderr. Un agent qui affirme que tous les tests passent alors que la suite est rouge est routé par la suite rouge, pas par son affirmation. Ce contrôle a son jumeau à l'entrée : un contrôle d'entrée s'exécute avant même que l'agent de l'étape soit lancé, à chaque entrée. Un code de sortie non nul, une coupure ou une commande qui ne peut pas se lancer ne démarre jamais l'étape, sans aucun tour de modèle consommé, et le run soit s'arrête avec la stderr de la commande sur sa timeline, soit saute à l'étape que vous désignez. Un coupe-circuit opérationnel qui tient, que l'agent lise ou non ses instructions.

Quatre yeux, en même temps

Éclatez un node en branches parallèles : QA déroule les parcours pendant que Sécurité audite le diff, chacun dans son propre agent, aveugle aux conclusions de l'autre. Un node de jonction attend toutes les branches, fusionne résumés, risques et flags, puis route sur le résultat combiné. Les conflits booléens se résolvent à false par construction : un seul relecteur en échec suffit à retenir la release.

Dev → [ QA ∥ Security ] → Release gate

Comment un run d'équipe se déroule

01

Ouvrez l'onglet Teams

Dans la vue projet, l'onglet Teams liste quatre modèles fournis (Coder puis vérifier, Spécifier coder vérifier, Chasse au bug, Bouclier de release) plus toutes les équipes déjà sauvegardées. Dupliquez un modèle ou cliquez sur 'New team'.

02

Construisez le workflow sur le canvas

Posez des nodes d'agent sur le canvas React Flow. Pour chaque node, choisissez le rôle (Fullstack, QA, Security, PM, etc.), le provider, le modèle, et quelques lignes d'instructions d'étape. Câblez-les avec des edges. Ajoutez des conditions sur les edges si vous avez besoin de branchement.

Dev → QA → PM
03

Définissez le mode de handoff par node

Handoff auto : l'agent appelle team_complete_step quand son travail est terminé, le runner prend le relais. Handoff manuel : l'agent attend que vous cliquiez sur 'Hand off'. Mixez les deux selon le besoin.

04

Lancez l'équipe

Depuis un ticket de backlog, cliquez sur 'Run with team'. Depuis un slot d'agent vide, cliquez sur 'Create as team'. Le premier node spawn comme agent éphémère dans le workspace projet.

05

Regardez le handoff se faire

Quand l'agent N termine, AgentsRoom construit le payload de handoff (résumé via l'agent ou via Haiku, diff git, risques, pistes de test, flags), ajoute une note dans NOTES.md, choisit le bon lien sortant selon les flags, et passe la main à l'agent N+1 avec ce payload comme contexte d'entrée. Si le node déclare une commande de contrôle, le runner l'exécute d'abord : c'est le code de sortie mesuré, pas la déclaration de l'agent, qui remplit le flag de routage.

06

Boucle, fin, finalisation

Les boucles de feedback ré-entrent dans l'agent original (mémoire complète préservée). Un node Await met le run en attente sur une question pour vous et le relance dès que vous répondez. Le node de fin déclenche awaiting-finalization et vous notifie, téléphone compris. Vous cliquez sur 'Finish run' : les agents sont détruits, leurs PTY libérés, et le ticket backlog d'origine est clôturé. Quand un agent pilote votre backlog, le run lui envoie aussi un message Agent Mail à chaque arrêt (fin atteinte, blocage, attente de votre réponse, run terminé ou annulé) : il peut finir le run et lancer le ticket suivant sans surveiller.

Une communication inter-agents qui survit à tout

Le détail que la plupart des démos multi-agents zappent. Voici ce qui fait tenir Agent Teams sur des runs longs et beaucoup de cycles.

Les agents Claude Code ont une fenêtre de contexte et ils la compactent. L'erreur classique des systèmes multi-agents, c'est de mettre la coordination de l'équipe uniquement dans le system prompt. Après deux cycles de /compact, l'agent n'a plus aucune idée qu'il est dans une équipe. AgentsRoom ne fait pas ça.

Toute la coordination d'équipe vit à trois endroits qui survivent à la compaction. Premièrement, un serveur MCP (agentsroom-team) expose des outils (team_get_context, team_read_notes, team_post_note, team_read_inbox, team_ask, team_read_timeline, team_read_diff, team_complete_step). Les outils MCP sont renvoyés à Claude à chaque tour par le CLI, donc ils sont immunisés contre la compression de contexte.

Deuxièmement, un hook UserPromptSubmit tourne avant chaque message utilisateur et préfixe un petit rappel s'il y a de nouvelles notes ou de nouveaux messages d'inbox pour ce rôle. Pas cher quand il ne se passe rien, décisif quand il se passe quelque chose.

Troisièmement, NOTES.md et state.json vivent sur disque dans le workspace. L'agent peut les relire à n'importe quel moment avec un simple Read ou avec team_read_notes. Ils survivent aux crashs, redémarrages, /clear, /compact et reboots machine. Le system prompt n'est jamais la source de vérité, le disque et les outils MCP le sont.

Au-delà du run

La boîte de l'équipe s'arrête avec le run. L'annuaire du projet, non.

Tout ce qui précède est limité à un run : les rôles sont des nœuds d'un graphe, la boîte de réception appartient au run, et les deux disparaissent quand il se termine. C'est la bonne forme pour un pipeline qu'on rejoue, et la mauvaise pour une question qu'un agent voudra poser à un autre mardi prochain.

La messagerie entre agents est l'autre couche. Les agents enregistrés du projet sont des membres permanents dotés de leur propre adresse et de leur propre boîte, ils s'écrivent par leur nom depuis n'importe quel CLI, et un message survit à un redémarrage, à un plantage et à un agent éteint au moment de l'envoi. Rien n'a été retiré aux Agent Teams : un membre permanent peut lancer un run, et un nœud de run n'est jamais promu en membre permanent.

Voir la messagerie entre agents
Tourne sans vous

Un run n'a pas besoin de commencer par votre clic.

Une équipe est l'une des deux choses vers lesquelles un déclencheur peut pointer, à côté d'un agent seul. Sur une planification, elle part sur un rythme de calendrier ou sur la fenêtre de quota de votre abonnement IA ; sur un webhook, elle part quand GitHub, GitLab, Slack, Linear, Sentry ou votre CI envoie l'événement. Votre prompt arrive à la première étape de l'équipe, le pipeline se déroule tout seul, sur votre machine, et vous recevez la notification habituelle au démarrage.

La frontière est simple : le déclencheur décide QUAND un run démarre et lui remet l'événement, l'équipe reste ce qui s'exécute. Le reste ne change pas, même passage de relais, mêmes connexions conditionnelles, mêmes boucles de retour, même timeline à relire ensuite.

Voir les déclencheurs : planification et webhooks

Ce que les gens construisent avec Agent Teams

Pipeline Dev vers QA

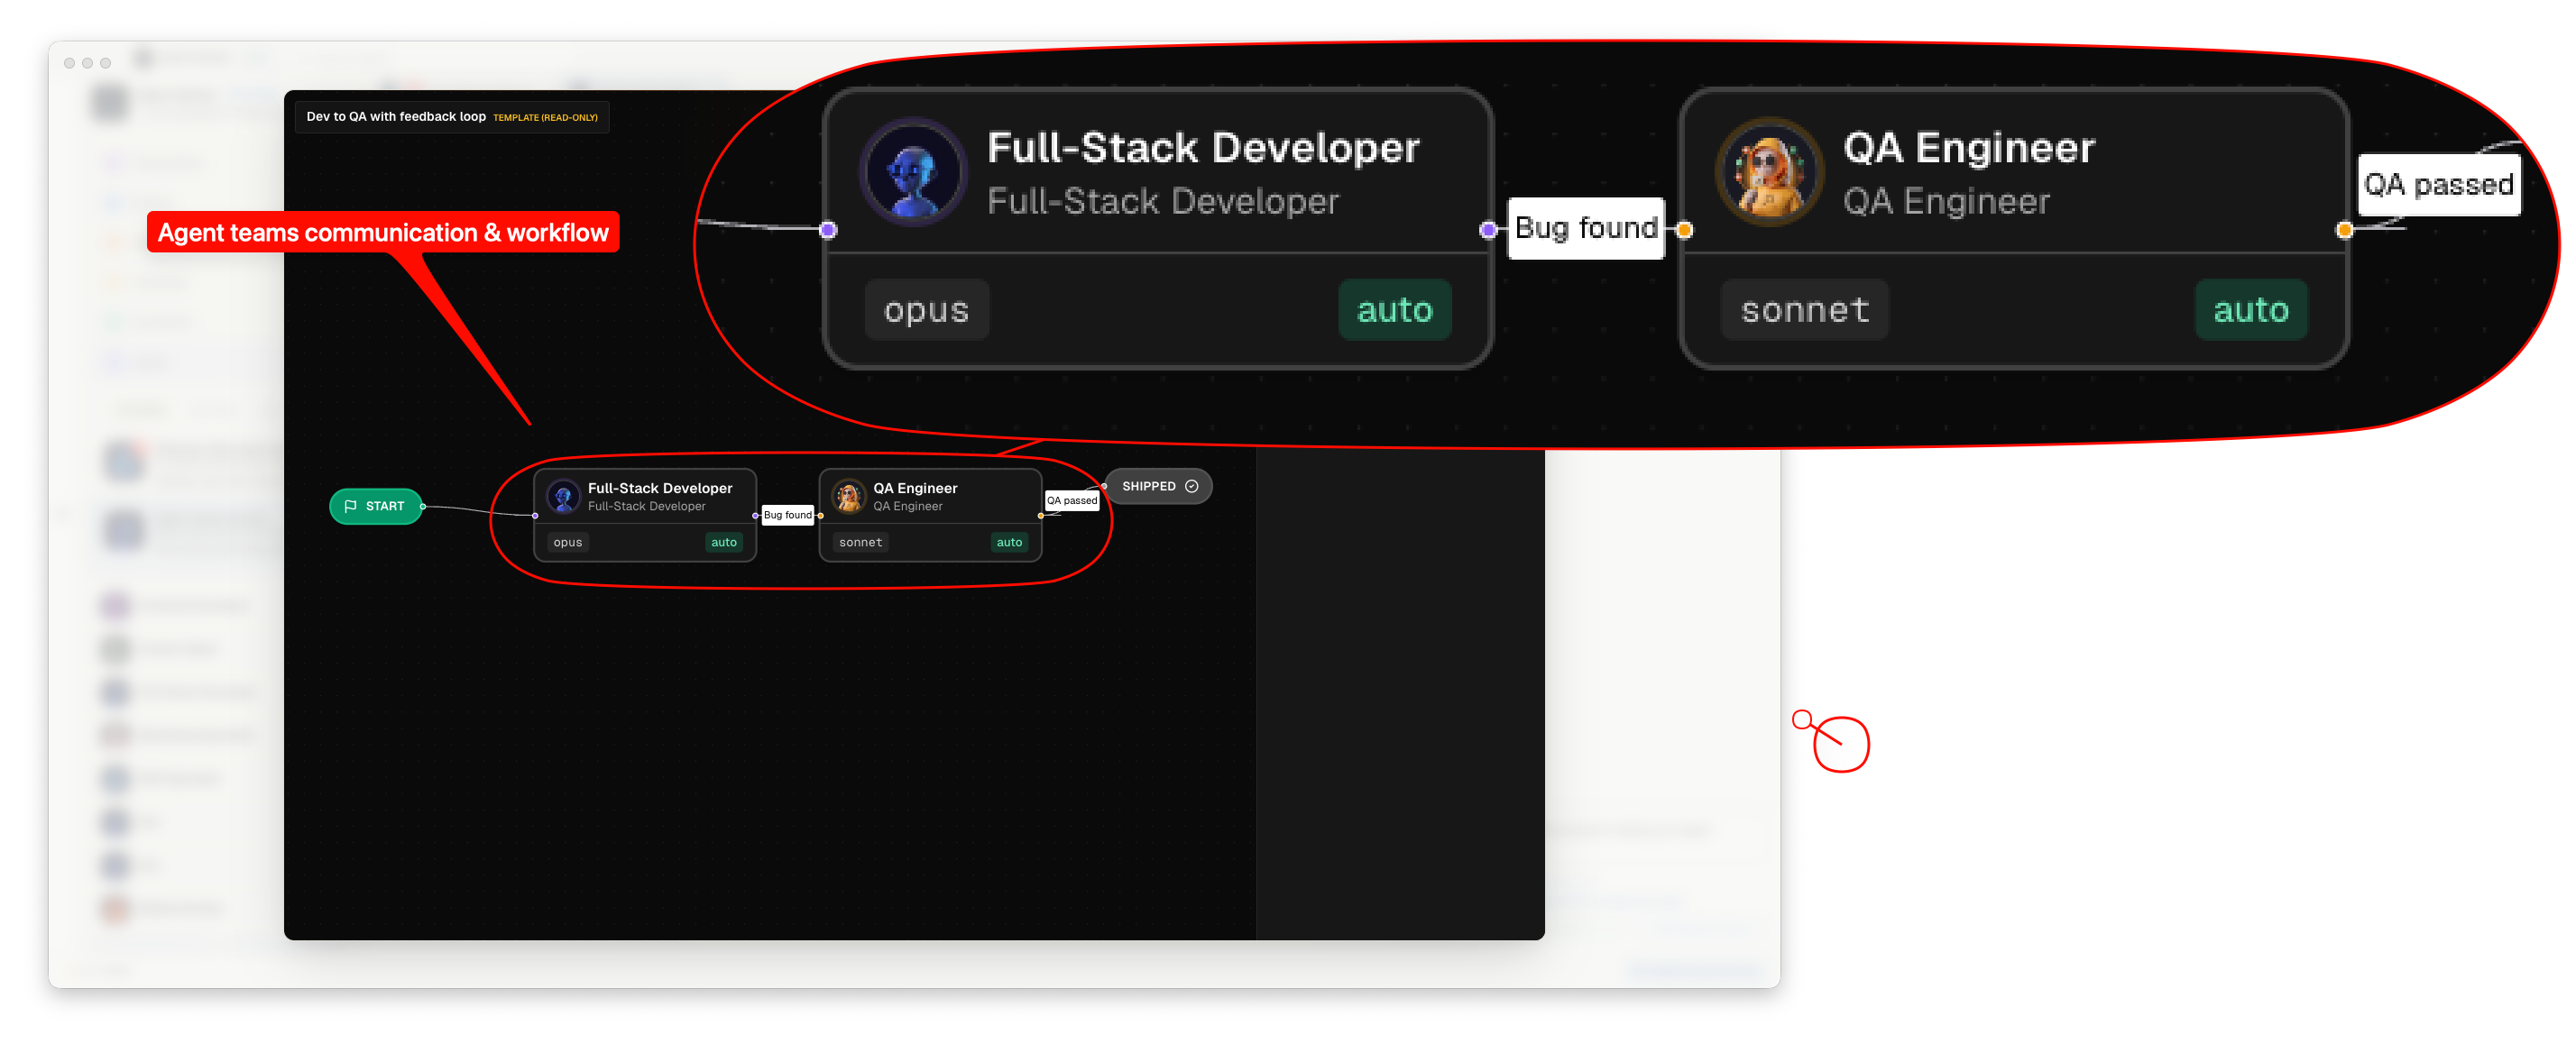
Le classique. Le Fullstack livre la feature. Le QA la valide dans le navigateur intégré, exécute les pistes de test, signe. Équipe à deux nodes, tourne sur chaque ticket du backlog.

Dev vers QA avec boucle de feedback

Comme au-dessus, mais avec un edge conditionnel : qaPassed equals false renvoie le ticket au Dev avec les pistes de test. Max 3 cycles. Attrape les régressions avant qu'elles n'arrivent à un reviewer humain.

Dev vers Security vers QA

Pour les features qui touchent à l'auth, aux paiements ou aux PII. L'agent Security review le diff, flag les risques, écrit des pistes de test pour le QA. Utilisé par les équipes qui livrent du fintech, du healthtech et du SaaS B2B.

PM vers Architect vers Dev

Workflow spec-first. L'agent PM transforme le ticket en spec structurée. L'Architect choisit l'approche. Le Dev implémente. Trois rôles, séparation propre, décisions traçables.

Fan-out Frontend, Backend, DevOps

Découpage séquentiel pour les features full-stack. Le Frontend livre l'UI. Le Backend livre l'API. Le DevOps ajoute la config infra. Chaque rôle bosse dans sa zone, fait son handoff avec un diff propre.

Marketing vers SEO vers i18n

Oui, AgentsRoom Teams n'est pas que pour le code. Le Marketing écrit le copy de la landing. Le SEO injecte les mots-clés. La Localization traduit en 20 langues. Une équipe, un ticket, une livraison.

Bouclier de release : QA et Sécurité en parallèle

Un node dev s'éclate en QA et Sécurité qui tournent côte à côte, puis une porte de release fusionne les deux rapports. Livré avec l'app en modèle. Tout le bouclier reboucle vers le Dev si l'une des branches signale un problème.

Chasse au bug : reproduire avant de corriger

Un agent QA reproduit le bug et note les étapes exactes. Un dev corrige la cause racine. Un second QA rejoue les mêmes étapes pour prouver le correctif. Fini le 'ça marche chez moi'.

Comment ça se compare aux autres approches multi-agents

L'orchestration multi-agents est un buzzword saturé. Voici ce qui livre vraiment, et où AgentsRoom Teams se positionne.

Anthropic Subagents (outil Task, .claude/agents) permet à une session Claude unique de déléguer à des agents helper spécialisés. Excellent pour la délégation inline, mais la session parente reste le coordinateur et un contexte unique. AgentsRoom Teams est un cran au-dessus : chaque node d'équipe est une session Claude top-level séparée avec sa propre fenêtre, son propre état, son propre scrollback. CrewAI, AutoGen et LangGraph sont d'excellents frameworks Python pour les flows multi-agents, mais ils vivent en dehors de votre IDE et ne font pas tourner de vrais Claude Code, Codex ou Antigravity CLIs end-to-end sur votre repo local. n8n, Make, Pipedream et Retool livrent le même genre d'éditeur canvas qu'on utilise, mais ce sont des plateformes d'automatisation généralistes, pas pensées pour les agents IA de code. AgentsRoom Teams est l'éditeur de workflow multi-agents façon canvas, mais câblé spécifiquement à vos agents CLI, votre projet, votre git, vos terminaux et votre navigateur.

Claude subagentsTask toolCrewAIAutoGenLangGraphn8nMakePipedreamRetoolTemporalAirflowPrefectDagster

Si vous construisez des systèmes agentiques en Python, continuez avec CrewAI ou LangGraph pour les pipelines de prod. Si vous livrez du code avec Claude, Codex, GitHub Copilot CLI, Cursor ou l'un des 13 autres CLI d'agent pris en charge par AgentsRoom, Agent Teams est le workflow d'équipe qui tourne là où vous codez vraiment.

FAQ

En quoi c'est différent des subagents Claude Code (l'outil Task, .claude/agents) ?

Les subagents Claude sont des délégations inline depuis une session Claude parente unique. Le parent décide quand appeler un subagent, le subagent tourne dans une fenêtre de contexte isolée, retourne un résultat, et le parent continue. AgentsRoom Teams est un cran au-dessus : chaque node est une session Claude Code top-level avec son propre terminal, son propre état et son propre scrollback. Vous voyez chaque agent tourner en live dans son onglet, vous pouvez parler à n'importe lequel à tout moment, vous pouvez mettre l'équipe en pause, changer le workflow et reprendre. Ce n'est pas un remplacement des subagents Claude, vous pouvez totalement utiliser les deux. Un node d'équipe peut utiliser des subagents en interne.

Ça marche uniquement avec Claude Code ?

Ça marche avec les 17 CLI d'agent supportés par AgentsRoom (Claude Code, Codex CLI, GitHub Copilot CLI, Cursor et 13 autres). Chaque node d'équipe choisit son propre provider et modèle. Les outils de coordination d'équipe basés sur MCP marchent à l'identique sur tous les providers parce qu'ils sont exposés via le standard Model Context Protocol. Vous pouvez faire tourner une équipe avec Codex sur le node backend lourd et Haiku sur le node QA si c'est ce qui colle à votre budget et à votre latence.

C'est quoi un payload de handoff ?

Un objet structuré qui voyage d'un agent au suivant. Champs : featureSummary (une description courte de ce qui vient d'être livré), changedFiles (git diff name-status), touchedAreas (UI, API, DB, config), risks (tout ce dont l'agent suivant doit se soucier), testHints (priorités pour le QA), flags (booléens comme qaPassed, utilisés par les edges conditionnels). L'agent appelle team_complete_step avec ce payload, le runner le valide côté serveur, l'agent suivant le reçoit comme contexte de départ.

Les agents peuvent vraiment faire des allers-retours (Dev vers QA vers Dev) ?

Oui. Quand un node est ré-entré (cycle supérieur à 1), AgentsRoom ne spawn pas un nouvel agent. Il réutilise l'agent original du cycle 1, écrit le nouveau payload de handoff directement dans son terminal existant, et l'agent garde toute sa mémoire de session Claude des cycles précédents. C'est critique : un agent Dev qui sait déjà ce que le QA a flaggé la fois d'avant corrige le bug. Un agent Dev frais sans mémoire répèterait juste la même erreur.

Qu'est-ce qui se passe si le QA rejette le Dev pour toujours ?

La config d'équipe a une garde max-cycles, par défaut à 3. Quand le plafond est atteint, le run s'arrête avec un statut 'blocked' et vous affiche le compte rendu du dernier handoff : accordez un ou deux cycles de plus et l'équipe reprend exactement là où elle s'était arrêtée, finalise le run, ou annule tout. Pas de boucles infinies, pas de factures surprise du jour au lendemain.

Tous les agents d'équipe partagent le même workspace git ?

Oui. Par défaut, l'équipe tourne dans un workspace unique et une branche unique (ou un worktree si vous utilisez la feature Worktrees d'AgentsRoom) : chaque agent voit le travail du précédent à travers git, et le payload de handoff inclut un diff git contre le baseline du run pour que l'agent suivant sache exactement ce qui est nouveau. Une étape peut aussi avoir son propre checkout jetable : cochez « Checkout dédié » sur l'étape et elle tourne dans un git worktree taillé sur un instantané du workspace du run, travail non commité compris, pour que les étapes parallèles qui mesurent ou relisent (une couverture de tests, une sonde) n'écrasent plus les fichiers les unes des autres. Rien de ce qui y est écrit n'atteint la branche du run, l'étape rapporte par son handoff et ses notes, et le checkout démarre sans dépendances installées. L'éditeur prévient quand deux étapes parallèles partagent le même arbre et que l'une d'elles peut écrire.

Ça demande un abonnement supplémentaire ?

Non. Teams fait partie d'AgentsRoom. Vous apportez vos propres clés provider (Claude, Codex, GitHub Copilot CLI, Cursor et 13 autres CLI d'agent) et vous payez seulement les tokens que vous consommez, comme avec un agent unique. Faire tourner une équipe Dev vers QA sur un petit ticket coûte généralement la même chose qu'un agent Fullstack unique, parce que Haiku/Sonnet sur l'étape QA c'est pas cher.

Où sont stockées les équipes ? Elles sont commitées dans git ?

Les équipes projet vivent avec la room, synchronisées à votre compte et mises en cache dans {project}/.agentsroom/teams-cache.json (gitignoré). Les équipes globales sont elles aussi synchronisées à votre compte : votre bibliothèque vous suit d'une machine à l'autre, avec ~/.agentsroom/teams/ comme cache hors-ligne. Les modèles fournis restent locaux : chaque machine les installe dans sa propre langue.

Qu'est-ce qui se passe si un agent crash ou que l'app redémarre en plein run ?

L'état du run est persisté sur disque dans {workspace}/.agentsroom/team-runs/{runId}/ (state.json, NOTES.md, inbox/, timeline.jsonl), avec écritures atomiques et notes en append-only. Un run interrompu reprend au redémarrage de l'app : l'orchestrateur ré-entre l'étape active, rouvre le terminal, et l'agent retrouve son contexte via les notes et les outils d'équipe. Un run dont l'équipe a été supprimée est clos automatiquement au lieu de traîner indéfiniment.

Je peux faire tourner plusieurs équipes en parallèle sur différents tickets ?

Oui. Chaque run est indépendant, identifié par son runId. Vous pouvez avoir trois équipes différentes en cours sur trois tickets du même projet. À l'intérieur d'un run, l'exécution suit votre graphe : séquentielle par défaut, parallèle là où vous tracez des branches parallèles (par exemple QA et Sécurité qui relisent en même temps), avec toujours une jonction déterministe.

Deux agents peuvent-ils vraiment tourner en même temps ?

Oui. Tracez deux liens sans condition depuis un node et les deux cibles tournent en branches parallèles, chacune dans son propre agent et son propre terminal. Les branches font un node de profondeur et doivent converger vers un node de jonction commun, ce que l'éditeur valide avant de vous laisser lancer. Quand toutes les branches ont terminé, la jonction reçoit un payload fusionné : résumés étiquetés par rôle, risques et pistes de test dédupliqués, et flags fusionnés avec une règle fail-safe (un conflit booléen se résout à false).

Comment fonctionnent les portes de qualité exactement ?

Vous tapez une commande shell sur le node, par exemple npm test, et si besoin un nom de flag (checkPassed par défaut). Quand l'agent signale la fin de son étape, AgentsRoom exécute la commande dans le workspace avec un plafond de cinq minutes. Code de sortie 0, le flag passe à true ; tout autre code, false, en écrasant ce que l'agent a déclaré sur lui-même. En cas d'échec, les derniers kilo-octets de sortie voyagent vers l'agent suivant : le retour en arrière atterrit avec la vraie stack trace, et le résultat s'affiche dans la timeline du run.

Une étape peut-elle charger mes procédures de la Skills Library ?

Oui. Chaque node peut épingler des skills de votre Skills Library, projet ou globale. L'agent reçoit l'instruction de les charger avant de commencer l'étape : une checklist de review, un runbook de déploiement ou une procédure de test est appliquée à chaque run, au lieu de dépendre de la mémoire de l'agent.

AgentsRoom vérifie-t-il mon graphe d'équipe avant de le lancer ?

Oui. L'éditeur exécute une série de contrôles de graphe et sépare les erreurs bloquantes des avertissements. Les erreurs arrêtent le run : nœud Start ou End manquant, connexions en double, deux connexions portant les mêmes conditions, une connexion dont les conditions se contredisent, un fan-out invalide. Les avertissements non : un nom de flag entouré d'espaces, une condition sur une connexion sortant de Start, un nœud dont toutes les connexions sortantes sont conditionnelles et où le run peut donc s'arrêter. Les deux sont listés dans un panneau de contrôles et les connexions fautives sont recolorées sur le canvas : vous corrigez le graphe avant de perdre un run dessus.

Un agent peut-il modifier l'équipe dans laquelle il tourne ?

Non, et c'est volontaire. Tant qu'un run est vivant, la définition de l'équipe est gelée contre les écritures venant des outils MCP : nœuds, arêtes, nombre maximum de cycles, instructions d'étape, skills, commande de vérification, rôle, provider et modèle passent en lecture seule pour les agents, une skill chargée par le run ne peut pas non plus être réécrite, et le gel ne se contourne pas en supprimant puis recréant l'équipe. Un agent ne doit pas réécrire la règle qui le gouverne. Vous, depuis l'interface, continuez à tout modifier à tout moment.

Puis-je lancer et suivre un run d'équipe depuis mon téléphone ?

Oui. L'application mobile peut démarrer une équipe sur un projet, affiche une bannière de run avec la progression de chaque étape, et donne accès au terminal de l'agent en cours. Le run lui-même s'exécute toujours sur votre poste, à travers les vraies CLI, exactement comme si vous l'aviez lancé depuis là.

Faut-il choisir le mode relais ou le mode équipe ?

Demandez-vous sur quoi le run échouerait. S'il échouerait en perdant le fil, prenez le relais : une seule session joue tous les rôles et ne se réexplique jamais une décision. S'il échouerait en étant d'accord avec lui-même, prenez l'équipe : les rôles tournent comme des agents séparés, donc celui qui relit le code n'est pas celui qui l'a écrit. Le relais est le mode par défaut parce que c'est déjà ce que font toutes les équipes construites avant l'existence du réglage, pas parce qu'il serait meilleur.

En mode équipe, est-ce que tous les agents démarrent en même temps ?

Non. Un coéquipier démarre la première fois qu'on a besoin de lui, soit parce que le graphe atteint son étape, soit parce qu'un autre agent lui écrit. Une équipe de quatre rôles ne brûle donc pas quatre sessions pour répondre à une question qui n'en concerne que deux. Quand une étape a passé la main et que le run ne peut plus y revenir, sa console est mise en veille pour libérer de la mémoire, et elle se réveille avec sa conversation intacte si quelqu'un lui écrit. Un rôle sollicité à nouveau lors d'un cycle suivant reste le même agent que celui qui a répondu avant, sauf si vous activez l'option d'équipe qui ferme la console de chaque étape quand elle passe la main : il repart alors de zéro.

Est-ce qu'un coéquipier se souvient de ce que les autres ont fait ?

Seulement de ce qu'il peut lire. Un coéquipier qui arrive en cours de run a sa propre session et aucun souvenir du travail, et c'est exactement pour ça que son avis vaut quelque chose. Il se met à jour via les notes partagées, la timeline du run et le diff git depuis le début du run, qu'il lit lui-même avec ses propres outils. Cette lecture est le coût du mode, et c'est la raison pour laquelle le mode relais existe toujours.

Peut-on empêcher les agents de s'écrire dans n'importe quel ordre ?

Oui, et c'est le comportement par défaut. Avec la conversation libre désactivée, un coéquipier ne peut écrire qu'aux rôles vers lesquels son nœud pointe dans le graphe, donc une porte de qualité ne peut pas être contournée en demandant à quelqu'un d'autre. Activez-la quand vous voulez une vraie équipe : chacun écrit à n'importe qui, dans n'importe quel sens, et à plusieurs à la fois. Dans les deux cas, le graphe démarre toujours le run et le termine toujours.

Une équipe peut-elle démarrer toute seule, sur une planification ou sur un webhook ?

Oui. Un déclencheur peut pointer vers une équipe plutôt que vers un agent seul, donc le même pipeline tourne sans surveillance : sur un rythme de calendrier, sur la fenêtre de quota de votre abonnement IA, ou sur un événement envoyé par GitHub, GitLab, Slack, Linear, Sentry ou votre CI. Le prompt part à la première étape de l'équipe, le run se passe sur votre machine comme n'importe quel autre, il atterrit dans l'historique du déclencheur, et une notification vous annonce qu'il a démarré. Les déclencheurs vivent dans le panneau Déclencheurs du projet, à côté des tâches planifiées.

Que devient un run arrivé à End que personne ne termine ?

Il vous attend, parce que terminer un run commite, fusionne son worktree et ferme son ticket, et que la dernière étape peut encore renvoyer du travail. Si vous préférez ne pas revenir le chercher, activez Terminer après inactivité dans les réglages de l'équipe et choisissez un délai (30 minutes proposées, jusqu'à 24 heures) : une fois le run à End et aucune étape active pendant ce délai, AgentsRoom le termine et libère ses consoles. Comme personne n'a vérifié ce travail, son ticket va alors dans la colonne En revue si votre tableau l'affiche (dans Terminé sinon), avec une note qui indique que le run s'est terminé tout seul. Il n'annule jamais un run qui travaille encore ou qui attend votre réponse, et l'option est coupée par défaut.

Puis-je choisir la direction d'un run à une étape Wait for me ?

Oui. Tirez des connexions conditionnelles depuis l'étape Wait for me, une par issue, par exemple approved = true vers Deploy et approved = false retour vers Dev. Quand le run s'y arrête, la boîte de réponse les liste sous Votre décision : celle que vous choisissez pose ses flags, le run prend cette connexion, et l'étape suivante sait que la décision vient de vous. Votre note devient facultative, et les mêmes choix sont proposés sur le téléphone.

Le Dynamic Island peut-il montrer un run d'équipe en une seule icône plutôt qu'un avatar par agent ?

Oui. Dans Réglages, Dynamic Island, Runs d'équipe, activez Afficher chaque run d’équipe comme une seule icône d’équipe. Chaque run prend alors une seule place, avec le blason de l'équipe et un point pour son état (rouge quand le run ou l'un de ses agents vous attend), et un clic ouvre la console qui a besoin de vous.

Pour aller plus loin

Construisez votre équipe dev IA de rêve

Quatre modèles livrés avec l'app. Ouvrez AgentsRoom, posez des nodes, tracez des liens, lancez sur n'importe quel ticket. Votre équipe d'ingénierie IA est à un clic.

GratuitTélécharger AgentsRoom

App companion : suivez vos agents en déplacement

Utilisez Claude, Codex, Antigravity CLI ou un autre fournisseur IA.

Installer l'extension
Chrome Web Store

Remontez bugs et demandes directement dans votre backlog public.

Multi-projets
Multi-provider
Multi-agents
Statut en direct
Diff & commit
App mobile
Aperçu live
Équipes d'agents
Tests navigateur
Dev pilotée par backlog
Bibliothèque de prompts
Bibliothèque de skills
Voir toutes les fonctionnalités